
模型能力决定 AI 视频生成的上限,但创作工作流决定创意落地的效率、稳定性与成本控制。
作者|甘德
编辑|郑玄
Seedance 2.5 发布时,身边几乎所有关注 AI 视频生成、AI 影视制作的人都非常兴奋。
「模型能力已经开始溢出了。」
一位从事 AI 短剧导演工作的朋友如此评价。他的实际体验是,如今只要有一个好故事、专业的影视制作经验,或一支足够成熟的抽卡团队,再配合相对充足的预算,Seedance 2.5 已经可以较为稳定地制作出达到甚至超过行业工业化水准的视频内容。
但这样专业、资金和经验都相对充足的创作者,终究还是少数。
过去一年,AI 视频模型的生成能力确实有了明显提升,但这些进步还没有被完整地转化为视频整体成片质量的同步升级。
答案或许就藏在那位 AI 短剧导演评价的后半句里。Seedance 2.5 是一块金子,但对大多数创作者而言,还需要一整套更完整、更专业的创作工具,才能把模型能力真正充分释放出来。LibTV 最近的更新,正是在更好地承接和放大前沿模型迭代带来的价值。
01
把模型的新 feature 变成可用工作流
Seedance 2.5 最大的变化之一,是它对参考素材的承载能力比 Seedance 2.0 提升了很多。在 Seedance 2.0 最多同时处理 9 张图片、3 段视频和 3 段音频的基础上,Seedance 2.5 已把全模态素材容量扩展到 50 个。
模型能够吃下更多上下文信息,但这些参考素材本身仍然需要被生产、整理、筛选和匹配。这正是 LibTV 的切入点所在。
LibTV 的智能拉片(Shot Breakdown),就是为了解决参考素材生产与调用效率的问题。
在传统影视制作流程中,拉片本就是创作前的重要基本功。导演、摄影、美术甚至剪辑,都会从成熟作品中拆解出独立镜头片段,作为后续创作参考。而「智能拉片」则把这件原本高度依赖人工的工作,变成了一个几乎可以一键完成的标准化工作流。
整个智能拉片的操作非常简单,你只需要把参考用的完整影片放进去,就能得到「分镜」、「动态」和「音乐」三个模块的拉片结果。比如用一段岩井俊二的电影片段作为素材,就能较为精准地拆分出这段内容中不同具体场景对应的三个分镜组。
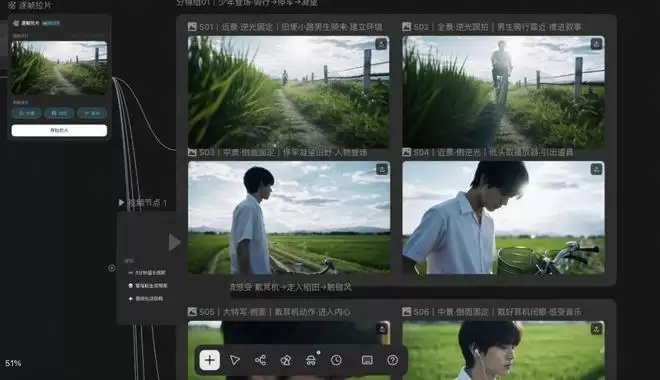
「智能拉片」提供的拆解方式包括「分镜」「动态」和「音乐」三种。刚才提到的是「分镜」,除此之外,「动态」部分还可以为参考影片的运镜方式提供分析依据;而参考片中的 BGM,也能在「音乐」模块中被较准确地提取和整理出来。
而且,这个拉片过程对算力积分的消耗是 0。
当参考素材的自动化生产问题被解决后,下一个更棘手的问题来了:这么多不同维度的素材,在实际创作过程中该如何整理、管理与匹配?
角色是正面还是侧面、远景还是特写、行动轨迹如何、道具和服装怎样统一、情绪和声音如何对应……一支 AI 视频在真正进入生成阶段前,往往已经拥有剧本、人物设定、视觉风格和大量参考图,但这些信息并不会自动转化为模型可直接理解的输入。对于创作者来说,如果这些工作仍主要依赖人工完成,那么 AI 节省下来的时间,很快就会被另一种形式的劳动重新吞掉。过去消耗在拍摄和剪辑上的成本,可能只是转移到了素材整理、提示词编写与反复试错上。
优质参考素材确实变多了,但管理难度也同步提高了。LibTV 的智能引用(AutoLink)解决的,正是「素材匹配」这一步。
当一个项目中包含大量角色、场景、道具和风格参考时,LibTV 会理解剧本内容,从画布素材中自动匹配相应参考,并把它们插入到提示词中对应的正确位置。

从参考素材的归纳与整理能力来看,难点并不完全在视频生成模型本身,更像是 AI 视频创作流程中的「工程化问题」。但当创作者对 AI 视频作品的细节质量、稳定性与时长要求越来越高时,智能拉片(Shot Breakdown)和智能引用(AutoLink)很可能会成为提升 AI 视频创作效率中,最容易被低估的一环。
而在 AI 视频创作最核心的视频生成环节,LibTV 也基于 Seedance 2.5 做出了一些颇具吸引力的能力增强。
02
生成更长,重拍更短
Seedance 2.5 把单次生成时长从 15 秒提升到了 30 秒。对于 AI 视频生成来说,更长的单段生成意味着在保证画面一致性的前提下,视频可以承载更完整的人物关系、更清晰的剧情结构,甚至尝试更丰富、更深入的镜头语言表达。
但对于更高质量的影视内容创作场景来说,30 秒依然不算长。
如果你想复刻一段像小津安二郎在《东京物语》中那样,围绕单一人物持续数分钟的固定长镜头对话,仅靠把多个 30 秒视频进行拼接,同时还要保证人物、环境完全一致,并实现多次无缝首尾帧衔接,这件事依旧非常困难。
LibTV 的超长视频(Long Video Direct)功能,把单次视频生成 30 秒的时长上限,进一步扩展到了 5 分钟。
你需要做的,还是像在 Seedance 2.5 中操作那样,把故事脚本、视觉风格和所有素材锚点放在画布上,再把参考图片、视频和音乐素材一并放上去。比如下面演示的案例,就是生成一个融合《芭比》和《MadMax》风格、高饱和度、略带暗黑气质并带一点韩风审美的 MV 视频。

另一个关键点在于,视频越长,可能需要修改的问题也越多。一个 5 分钟的视频里,问题可能出现在第 12 秒的人物表情,也可能出现在第 2 分钟的角色动作,或者任何一个前后帧之间的画面衔接不连贯。如果每次修改都需要重新抽卡,那么生成时长变长这件事,对创作者而言就没有真正的正向价值。
所以,LibTV 生成的这支 5 分钟视频,并不只是一次性产出的成片,更应该被看作一个全流程可继续编辑的项目。
整个视频中的所有镜头节点都会被完整保留下来。创作者可以清楚看到它由哪些片段组成,然后像传统视频剪辑那样,逐段检查、局部返工并持续完善。于是,长视频不只是「变长了」,而是变得可拆解、可修改、可迭代。对于真正需要交付作品的创作者来说,这一点比单纯拉长生成时长更重要。
除此之外,即便回到目前 AI 视频生成最基础的抽卡环节,LibTV 依然认为这里还有提升空间。
Seedance 2.5 的抽卡成功率相比 2.0 已经提升很多,许多镜头基本可以一次抽中,也支持对具体时间段和画面内容进行调整。但在真实制作流程里,局部修改依旧可能牵一发动全身。
从 Seedance2.0 到 Seedance2.5,虽然模型已经能够对特定时间段和画面内容进行调整,但没有改变的一点是:修改后仍需要重新生成整条视频。如果创作者对内容的修正只能通过再次抽卡来完成,那么从 15 秒到 30 秒再到 5 分钟,视频越长,创作成本也会越高。并且每次重新抽卡时,上一版中原本满意的部分,仍有可能被一起改动。
如果用真实拍摄做类比,当一段素材整体合格、只是个别镜头有瑕疵时,最优解显然不是全部重拍,而是针对有问题的部分进行「补拍」。
LibTV 新推出的「片段重拍」功能,关注的正是如何把生成视频的改动范围尽可能缩小。比如——30 秒的视频里如果只有 2 秒出错,那就只改这 2 秒。
这里有一段人物眼神特写的视频,如果现在希望画面中的蓝眼睛短暂变成红色,然后再恢复成蓝色,只需要在这段已生成视频的基础上,继续给出带有明确时间戳信息的 prompt 即可。
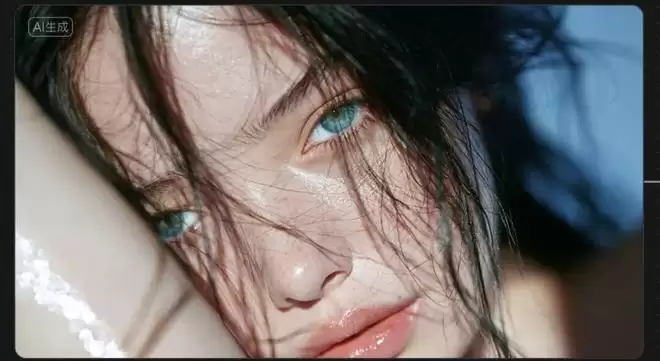
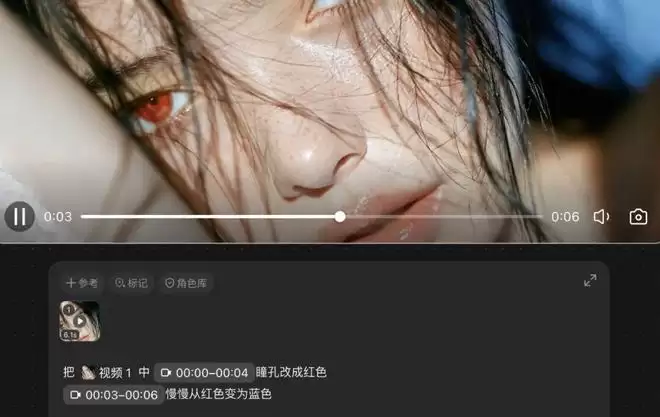
LibTV 在不同长度的视频生产过程中释放出的一个明确信号,是它对局部修改能力的高度重视。这背后其实也反映出,头部 AI 视频工具对创作者真实需求的判断正在发生变化:AI 视频工具的重心,正在从「生成逻辑」逐渐转向「制作逻辑」。所谓生成逻辑,关注的是模型一次性能做成什么;而制作逻辑,更在意一部作品究竟是如何被做出来的——素材如何被反复调整、如何被多人协同推进、如何被高效复用,最终又如何完成交付。前者足够吸引关注,后者才真正决定 AI 视频创作能否在现实生产场景中站稳脚跟。
03
理解模型,不该成为创作者的工作
今天,专业 AI 创作者仍然面临一个隐形门槛:理解模型。
在「AI 为视频创作带来平权」的叙事里,现阶段一个常被忽略的事实是:绝大多数创作者,并不是天然靠近 AI 的那群人。他们面对的,往往是一个个孤立的黑盒模型,而不是一整套成熟、顺手的创作工具。
这本来就不应该是创作者必须承担的工作。
导演应该理解镜头语言,而不必去理解模型的脾气;设计师应该理解视觉表达,而不必研究不同模型的输入偏好。AI 视频要真正成为创作基础设施,这部分关于模型的理解能力,应该被下沉到工具层中。
在 AI 内容创作这件事上,模型提供底层能力,AI 视频平台负责整合创作工具,但没有任何一方会比创作者本身更重要。
LiblibAI 最早被许多人理解为 AI 绘画时代的模型社区。它把模型、提示词、作品与创作者连接在一起,让原本分散的开源模型生态更容易被使用。到了今天,LibTV 更强调的是 20 多个独家专业功能、50 多个顶尖模型聚合、100 多个 AI 导演 Skill,以及一个庞大的创作者社区。
这些数字本身并不是最核心的竞争力。真正重要的是,LibTV 对视频创作工作流的理解深度,这也是它能在众多 AI 视频平台竞争中,持续获得创作者认可的重要原因。
模型能力决定视频的上限,但工作流决定创意兑现的效率、确定性和成本。Seedance 2.5 再次抬高了 AI 视频生成的能力上限,而 LibTV 想解决的是另一件事:让这个上限不只属于那些既懂影视、又懂模型,同时还拥有足够资金的人。
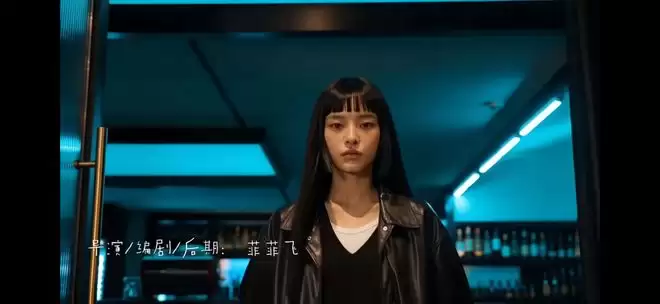
前段时间爆火的《被裁掉的女孩》,就是一个侧面案例。
这部由导演菲菲飞和团队打造的 AI 短剧,上线还不到 30 天,播放量就突破了 1 亿。20 岁到 27 岁期间,菲菲飞曾做过模特,因此这部短剧中的不少故事灵感,都能看到她真实经历的投射。再往后看,随着 LibTV 团队版、资产管理、工作流等新能力陆续上线,《被裁掉的女孩》这样的爆款 AI 短剧,才真正拥有了更稳固的落地基础;也正是在这一过程中,菲菲飞第一次把 AI 短剧打磨成了一套可以持续生产、持续更新的创作流程。
换句话说,模型能力越强,创作者越不应该把主要精力消耗在理解模型本身上。
如何创造一种新的语言,让模型真正与创作者站在同一侧,让创作者能够比以往更专注地思考作品中的故事、人物、镜头与节奏——这正是 LibTV 现在试图回答的问题。
*头图来源:LibTV