
一份采购询价单发出后,附带着清晰的物料清单,十二家供应商陆续回复。但真正开始比价前,你往往会先遇到一个更现实的问题:没有两家的报价格式完全一致。一家回的是 Excel 工作簿,价格列写成 "Unit Price",数量列写成 "Qty";另一家发来 PDF,同样的两列却变成了 "Rate" 和 "Pcs";第三家用欧元报价,数量列使用的是 Lot 而不是 Qty,还在脚注里注明“价格含运费、不含增值税”。在你能逐行比较任何报价明细之前,这些字段、单位和币种都必须先统一到同一种语义。
vendor_a.xlsx   Part No   | Description   | Qty | Unit Price | Total
vendor_b.pdf    Item      | Specification | Pcs | Rate       | Amount
vendor_c.xlsx   SKU       | (空)         | Lot | Unit Cost  | Net (EUR)
同样一份供应商报价信息,出现了三种字段命名、三种数量表达方式,还夹杂一次币种换算。本文将完整演示一个基于 .NET 的采购报价处理方案:如何把这样的报价收件箱,自动整理为一份可排序的采购建议清单。使用的工具是 Spire.Agent.Office——更关键的是,整个设计始终坚持一条明确边界:
智能体负责理解供应商字段的含义;你的应用负责决定每个零件由哪家供应商胜出。
| 智能体(语义层) | 应用(确定性层) |
|---|---|
把 Rate / Unit Cost / Unit Price 映射为 unitPrice | 把币种统一换算成美元 |
| 从 PDF 与 Excel 报价单中提取明细 | 校验数量、单价与总价是否一致 |
把 Qty / Pcs 映射为 quantity(Lot 仅在明确表示报价数量时) | 执行打分规则,并为每个零件选出中标供应商 |
后面的全部实现都围绕这条边界展开:智能体负责把异构的 Office/PDF 报价文件落到统一的规范结构(canonical schema)中;应用负责所有参与采购决策的数字计算与规则判断。
1. 定义规范报价结构
做供应商报价对比的第一步,永远是先定义一个所有报价都能归约到的目标结构。最直接的方式,就是把它定义为一个普通的 C# 模型——这就是规范结构:
public sealed class QuoteLine
{
    public string Vendor { get; set; } = "";
    public string? Part { get; set; }
    public string? Description { get; set; }
    // 可空:智能体在字段缺失或含义不清时留 null。
    public decimal? Quantity { get; set; }
    public decimal? UnitPrice { get; set; }
    public string? Currency { get; set; }
    public decimal? Total { get; set; }
    public int? DeliveryWeeks { get; set; }
    public int? PaymentTerms { get; set; }

    // 由应用在校验阶段写入 —— 智能体从不碰它。
    public string? Flag { get; set; }
}
从供应商自己的字段表头映射到这个统一结构,正是整个采购报价自动化流程的核心:
| 源字段(每家不同) | 规范字段 | 示例 |
|---|---|---|
Part No / Item / SKU | Part | A-1024 |
Qty / Pcs | Quantity | 500 |
Lot(仅当文档明确将其作为报价数量) | Quantity | 5 |
Unit Price / Rate / Unit Cost | UnitPrice | 12.50 |
Net / Amount / Total | Total | 6,250.00 |
| 文档中标明的币种符号 / 代码 | Currency | EUR |
Delivery / Lead Time | DeliveryWeeks | 4 |
Terms | PaymentTerms | 30 |
如果靠手写解析器,每新增一家供应商,通常都得重新处理一遍这张映射表;而智能体的价值,就在于它是按字段含义理解报价内容,而不是单纯按字符串做死板匹配。
2. 加载异构的报价
实际的采购收件箱,往往就是一个同时存放多种报价文件的目录,没有额外的人工预处理步骤:智能体可以直接按原生格式读取每个文件,因此 PDF 与 Excel 报价可以通过同一套流程处理,只是底层对象类型不同。
C:sourcinginbox
   ├─ vendor_a.xlsx
   ├─ vendor_b.pdf
   └─ vendor_c.xlsx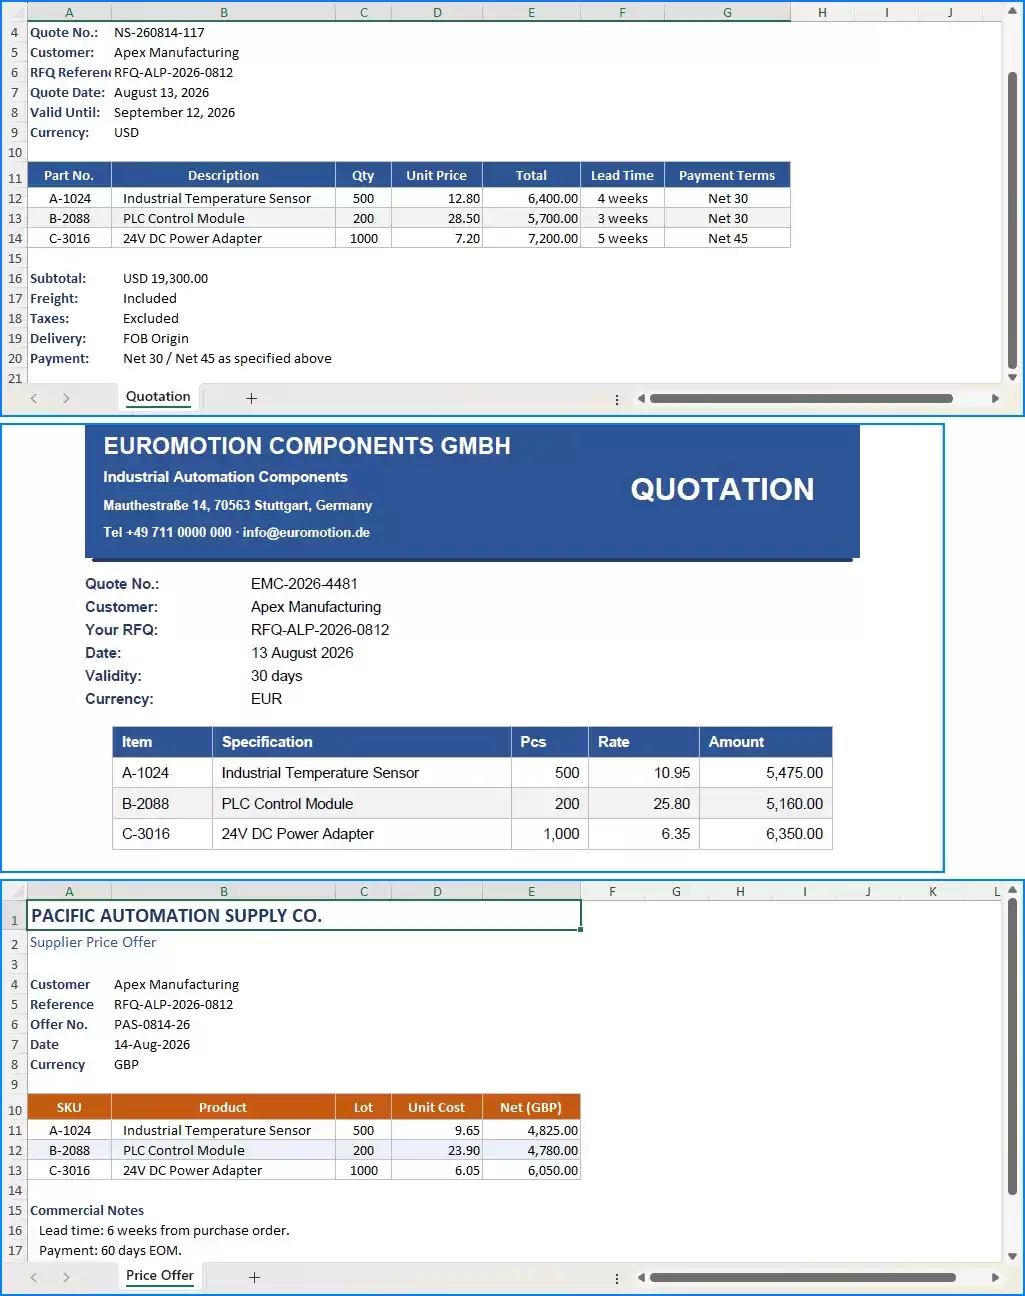
3. 用智能体把每份报价归一化
Spire.Agent.Office 为 Word、Excel、PowerPoint、PDF 统一提供了一个 AI() 处理器。安装 NuGet 包、完成一次性智能体配置后,就可以遍历报价收件箱,将每份供应商报价自动归一化:
dotnet add package Spire.Agent.Officeusing Spire.Agent.Office.AI;
using Spire.Agent.Office.Extensions;
using Spire.Pdf;
using Spire.Xls;
AIOptions agent = new AIOptions
{
SpireToken = spireToken, // 从你的 Spire.Agent.Office 账户获取
WorkDir = @"C:sourcingwork",
TimeoutMs = 300_000
};
const string instruction =
"读取这份供应商报价,提取明细。在输入文档所在的同一个目录下新建一个 .json 文件," +
"向其中写入一个 JSON 数组,每个明细行一个对象,每个对象只能包含这些字段:vendor、" +
"part、description、quantity、unitPrice、currency、total、deliveryWeeks、paymentTerms。" +
"vendor 是签发这份报价的公司,取自文档表头,绝不能留 null。deliveryWeeks 和 " +
"paymentTerms 是整数:deliveryWeeks 是交货周期(周),paymentTerms 是" +
"付款期限(天),所以 'Net 30' 要变成 30。把供应商" +
"自己的表头映射到这个结构上——'Rate'、'Unit Cost'、'Unit Price' 都表示 unitPrice;'Qty'、" +
"'Pcs' 都表示 quantity;'Lot' 仅在文档明确将其作为报价数量时才映射。若某个值缺失或" +
"含义不清,留 null,不要猜测。输出文件是交付物——必须确实创建并写入磁盘。";
foreach (string file in Directory.GetFiles(inboxPath))
{
string jsonPath = Path.Combine(normPath, Path.GetFileNameWithoutExtension(file) + ".json");
// 智能体调用走 LLM,偶尔会失败或不写输出文件;重试几次。
AIResult r = null!;
Exception? last = null;
for (int attempt = 1; attempt <= 3; attempt++)
{
try
{
if (file.EndsWith(".pdf", StringComparison.OrdinalIgnoreCase))
{
using var quote = new PdfDocument();
quote.LoadFromFile(file);
r = quote.AI(agent).ExecuteInstruction(quote, instruction, jsonPath, Array.Empty());
}
else
{
using var quote = new Workbook();
quote.LoadFromFile(file);
r = quote.AI(agent).ExecuteInstruction(quote, instruction, jsonPath, Array.Empty());
}
}
catch (Exception e) { last = e; }
if (r is not null && r.Success) break;
}
if (r is null || !r.Success)
throw new InvalidOperationException($"归一化失败 {Path.GetFileName(file)}:{r?.ErrorMessage ?? last?.Message}");
} 每次调用都会返回一个 AIResult。执行完成后,每一份供应商报价都会生成一份符合统一规范结构的 JSON 文件——例如 vendor_b.pdf 导出的字段会与 vendor_a.xlsx 完全一致。到这一步为止,智能体做的事情仅限于语义识别、字段提取和结构映射,并不参与任何金额计算或采购决策。
这套附件机制还可以进一步扩展:例如把历史采购价格表、零件规格书与当前报价一起作为附件传入,智能体就能帮助标记那些与常规价格明显偏离的报价明细——这类判断往往很难仅靠固定阈值编码完成。但它依然应该保持“建议”属性:由智能体提出可疑点,由你的业务代码最终决定如何处理。

4. 校验数据并换算币种
从这里开始,流程进入确定性处理阶段。把每份归一化后的 JSON 报价文件读回模型后,使用固定汇率表统一换算成单一币种,再把明显不成立的数据行标记出来或剔除:
using System.Text.Json;

private static readonly Dictionary Fx = new()
{
    ["USD"] = 1.00m,
    ["EUR"] = 1.09m,
    ["GBP"] = 1.27m,
};

var quotes = new List();
foreach (string json in Directory.GetFiles(normPath, "*.json"))
{
    quotes.AddRange(JsonSerializer.Deserialize>(File.ReadAllText(json),
        new JsonSerializerOptions { PropertyNameCaseInsensitive = true })!);
}

foreach (var q in quotes)
{
    if (string.IsNullOrWhiteSpace(q.Part)) q.Flag = "缺少零件号";
    else if (q.Quantity is null or <= 0)   q.Flag = "数量非正";
    else if (q.UnitPrice is null or <= 0)  q.Flag = "单价非正";
    else if (!Fx.TryGetValue(q.Currency ?? "", out var fx))
                                           q.Flag = $"不支持的币种:{q.Currency ?? "(无)"}";
    else if (q.Total is null)              q.Flag = "缺少总价";
    else if (q.DeliveryWeeks is null)      q.Flag = "缺少交期";
    else if (q.PaymentTerms is null)       q.Flag = "缺少付款条款";
    else if (Math.Abs((q.Quantity.Value * q.UnitPrice.Value
                     - q.Total.Value) * fx) > 0.01m)
                                           q.Flag = "数量 × 单价 ≠ 总价";
} 汇率表、校验阈值以及实际的计算逻辑,都应该明确写在代码里。只有这样,这些采购规则才真正具备可审查、可版本管理、可追踪的特性,也便于在审计或争议场景中直接引用。任何缺少汇率配置的币种,都应当被显式标记,而不是默认按美元静默处理;同样,凡是参与评分却被智能体保留为空的字段,也必须被清晰标识出来。Description 是唯一允许为空的字段,因为它本身不参与任何采购打分与中标判断。换句话说,智能体从始至终都不负责这些业务判断,它只负责把字段读出来。
5. 用确定性规则打分排序
当一条报价明细通过校验后,就可以进入打分和排序阶段。权重来自固定函数,而不是模型“主观认为”哪家更好:
private const decimal PriceTargetUsd = 15.00m;   // 每件预算

private static double Score(decimal unitUsd, int deliveryWeeks, int paymentTerms)
{
    double price    = unitUsd <= PriceTargetUsd ? 50.0
                    : 50.0 * (double)(PriceTargetUsd / unitUsd);
    double delivery = deliveryWeeks <= 4 ? 30.0 : 0.0;
    double terms    = paymentTerms >= 30 ? 20.0 : 0.0;
    return price + delivery + terms;
}
将这套评分规则应用到每一条有效报价行,完成排序后,再输出两份供后续采购建议读取的数据集——一份是排序后的有效报价,一份是被剔除的异常行。这里的每一行都已经通过第 4 步的数据校验,因此字段必然非空,! 和 .Value 只是为了让编译器通过空值检查:
public sealed record RankedQuote(
    string Vendor, string Part, decimal UnitUsd,
    int DeliveryWeeks, int PaymentTerms, double Score);

var scored = new List();
foreach (var q in quotes.Where(q => q.Flag is null))
{
    decimal unitUsd = q.UnitPrice!.Value * Fx[q.Currency!];
    int delivery    = q.DeliveryWeeks!.Value;
    int terms       = q.PaymentTerms!.Value;
    scored.Add(new RankedQuote(q.Vendor, q.Part!, unitUsd, delivery, terms,
        Score(unitUsd, delivery, terms)));
}
scored.Sort((a, b) => b.Score.CompareTo(a.Score));

var flagged = quotes.Where(q => q.Flag is not null).ToList();

File.WriteAllText(@"C:sourcingdataranked-quotes.json",
    JsonSerializer.Serialize(scored, new JsonSerializerOptions { WriteIndented = true }));
File.WriteAllText(@"C:sourcingdataflagged-lines.json",
JsonSerializer.Serialize(flagged, new JsonSerializerOptions { WriteIndented = true })); 
6. 生成采购建议
最后一步,再把结果交回给智能体——但它承担的是基于排序结果的文档撰写,而不是供应商选择。排序在第 5 步已经确定,赢家也已经由代码选好——每个零件对应一家供应商:
using Spire.Doc;

// 每个零件一位赢家,由代码决定,不由模型决定。
string winners = string.Join("、", scored
    .GroupBy(v => v.Part)
    .Select(g => g.OrderByDescending(v => v.Score).First())
    .Select(w => $"{w.Vendor}({w.Part})"));

// 智能体从指令里读取数据,而不是作为文件附件。
string rankedJson  = File.ReadAllText(@"C:sourcingdataranked-quotes.json");
string flaggedJson = File.ReadAllText(@"C:sourcingdataflagged-lines.json");

using (Document report = new Document())
{
    string instruction = $"""
        写一份采购建议。
        排序后的明细(已评分并按得分降序,每行一个对象):{rankedJson}

        被剔除、未参与评分的异常行(每条都带 "flag" 字段):{flaggedJson}

        各零件的获胜供应商是:{winners}
        严格按上面给出的结果写明每个零件的赢家。

        点名排序前三的明细,附上排序明细的对比表(供应商、零件、美元单价、交期、条款、
        得分),列出异常行,用一句采购员能直接行动的
        白话解释每条异常的原因。
        不要重新计算得分,也不要另选赢家。
        保持排版干净、可打印。
        """;

    AIResult result = report.AI(agent).ExecuteInstruction(
        report,
        instruction,
        @"C:sourcingoutputpurchasing-recommendation.docx",
        Array.Empty());

    if (result is null || !result.Success)
        throw new InvalidOperationException($"报告生成失败:{result?.ErrorMessage}");
} 赢家是作为明确的结果数据写进指令中的,而不是让模型根据排序自行推导出来:物料清单中的每个零件,分别授予得分最高的供应商。它读取排序数据,是为了生成表格和文字说明;真正的决策在前面已经完成,指令中也明确禁止它重新计算或改判。把 sa vePath 换成 .pdf,同一条指令还可以直接导出可分发的采购建议文件。异常标记同样是在第 4 步由代码判定的——智能体从未真正“裁决”任何一条报价。它在这一侧的价值,是处理语言表达:把 Flag 中像 数量 × 单价 ≠ 总价 这样的系统标记,改写成采购经理一眼就能理解并采取行动的自然语言,而不是重新判断这个标记是否成立。代码负责判定,模型负责叙述——同一条边界,在输出环节依然成立。

7. 检视智能体会话
每次 ExecuteInstruction 调用都会以会话(session)方式运行,Spire.Agent.Office 会把输入文件、生成结果以及执行产物一并保存在 WorkDir 目录下:
C:sourcingwork
└─ .office_use_tmp
   ├─ Excel
   │  └─ 0814140210_a1b2c3d4        ← vendor_a.xlsx 归一化
   │     ├─ vendor_a.xlsx
   │     └─ normalized.json
   ├─ Pdf
   │  └─ 0814140223_e5f6a7b8        ← vendor_b.pdf 归一化
   │     ├─ vendor_b.pdf
   │     └─ normalized.json
   └─ Word
      └─ 0814140411_c9d0e1f2        ← 推荐文档生成
         ├─ ranked-quotes.json
         └─ purchasing-recommendation.docx
这个会话目录本身就是一份完整的处理记录——处理了哪些供应商报价、输出了哪些结果,都可以回溯查看,因此也天然构成了整个采购工作流的审计轨迹。重点并不在于智能体内部究竟如何完成字段提取:在应用层面,异构的供应商报价文档已经被统一归约到同一套规范结构中,而校验、汇率换算、评分、排序和供应商中标选择则全部保留在你的代码里,过程显式、规则确定。
这也正是这套采购报价输出能够在真实业务流程中被信任的关键原因。假如供应商对某个数字或比价结果提出异议,你可以直接回到会话目录,准确展示他们的报价是如何被读取、映射和纳入流程的。
8. 完整工作流
整个采购报价自动化流水线,从头到尾如下:
static void Run()
{
    AIOptions agent = new() { SpireToken = spireToken, WorkDir = workDir, TimeoutMs = 300_000 };

    NormalizeQuotes(agent, inboxPath, normPath);       // 第 3 步 —— 智能体,语义
    var quotes = LoadAndValidate(normPath);             // 第 4 步 —— 代码,确定性
    var (scored, flagged) = ScoreAndRank(quotes);       // 第 5 步 —— 代码,确定性
    WriteDatasets(scored, flagged);                     //         序列化为 JSON
    GenerateRecommendation(agent, outputPath);          // 第 6 步 —— 智能体,写文档
}
这套设计真正值得复用的,其实并不只是“供应商报价比价”这一个具体场景,而是它先把边界划分得非常清楚:语义提取,也就是从异构的 Office/PDF 文档中读出字段含义,这部分交给智能体;至于每一个定量决策,例如币种换算、数据校验、评分与排序,则明确放在你的业务代码中。这样的切分方式并不只适用于采购询价和报价分析,放到发票处理、简历筛选、RFP 响应等场景同样成立:真正需要替换的,只是规范结构、提示指令和评分函数,而始终可以复用的,是这条清晰的系统边界。
如果你想自己跑通这套流程,可以先查看 Spire.Agent.Office 的集成入门教程,了解安装与配置步骤;产品概览中则列出了 SDK 当前暴露的四类智能体(Word、Excel、PowerPoint、PDF)。