
etcdctl是集群级备份灾难恢复,velero是业务级资源备份。两者不是替代关系,是互补关系,各有优缺点,最后再详细对比,先熟悉一下etcdctl如何备份和恢复Kubernetes集群。
今天我们来深入聊聊Kubernetes集群的备份。说到备份,很多朋友会想到Velero,没错,它确实是业务资源备份的利器。之前我们也分享过一篇关于Velero搭配MinIO搭建稳定备份方案的文章(《K8S别再裸奔了!手把手教你搭建Velero+MinIO最稳备份组合》),有兴趣可以回顾一下。
那么,etcdctl又扮演什么角色呢?简单来说,两者的定位截然不同:etcdctl是集群级的“数据库”备份与灾难恢复工具,而Velero则是业务级的“应用资源”备份工具。它们之间并非替代关系,而是互补关系,各有其适用场景和优缺点。在文章最后,我们会做一个详细的对比。现在,让我们先聚焦于etcdctl,看看如何用它来为你的Kubernetes集群上一道保险。

1. etcdctl 是什么?
简单讲,etcdctl是etcd官方提供的命令行客户端工具,用于直接与etcd数据库交互。在Kubernetes的语境下,由于整个集群的状态(包括节点、Pod、Service、ConfigMap等所有资源对象)都存储在etcd中,因此,通过etcdctl对etcd进行备份和恢复,就等同于对整个Kubernetes集群进行了一次“全量快照”式的备份与恢复。
2. etcdctl 安装
(1) 查看 etcd 版本
第一步,需要确定你集群中etcd的版本。一个非常关键的原则是:etcdctl客户端的版本必须与etcd服务器的大版本保持一致,否则备份和恢复操作很可能失败。
可以通过在Master节点上执行以下命令来查看:
kubectl exec -n kube-system etcd-k8s-master -- etcdctl version
(2) 下载对应版本
根据上一步查到的版本号(例如v3.5.21),到etcd的GitHub Release页面下载对应的二进制包。
wget https://github.com/etcd-io/etcd/releases/download/v3.5.21/etcd-v3.5.21-linux-amd64.tar.gz如果网络下载速度慢,也可以手动去GitHub页面下载后上传到服务器。
【重要提示】 务必确保etcdctl与etd服务器大版本一致,这是后续所有操作成功的前提。
(3) 安装
下载完成后,解压并安装即可:
tar -zxvf etcd-v3.5.21-linux-amd64.tar.gz
cp etcd-v3.5.21-linux-amd64/etcdctl /usr/local/bin/
# 添加执行权限
chmod +x /usr/local/bin/etcdctl
# 验证安装,查看版本
etcdctl version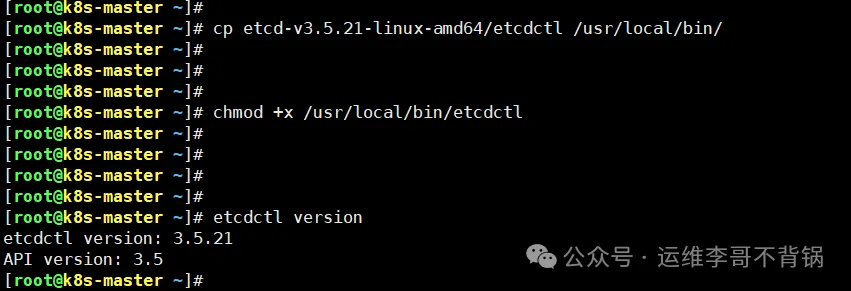
3. etcdctl 备份
无论你的集群是单Master节点还是多Master高可用架构,备份的流程都是一样的,操作在任一Master节点上执行即可。
(1) 设置 API 版本
首先,需要明确指定使用etcd API的版本,目前主流是v3。
export ETCDCTL_API=3(2) 执行备份命令
接下来,执行核心的备份命令。这里有几个关键参数需要理解:
# 创建备份目录
mkdir /backup
# 执行备份,生成快照文件
etcdctl snapshot sa ve /backup/etcd-`date +%F`.db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key
参数解析(必须理解):
--endpoints: 指定etcd服务地址,通常是本地2379端口。--cacert, --cert, --key: 提供连接etcd所需的TLS证书,路径通常在/etc/kubernetes/pki/etcd/下。
这个备份过程的本质,是生成一个etcd数据的一致性快照,类似于数据库的冷备份,能保证数据的完整性和一致性。
(3) 验证备份
备份完成后,强烈建议立即验证备份文件的有效性。
etcdctl snapshot status /backup/etcd-2026-03-19.db -w table
看到类似上图的输出,显示哈希值、修订版本等信息,就说明备份成功了。最后,别忘了将这个备份命令加入定时任务(如Crontab),实现定期自动备份,这是防止数据丢失的最佳实践。
4. 单 Master 节点恢复
单Master节点的恢复流程相对直观。请务必记住一个核心前提:在开始还原操作之前,必须先停止所有etcd和Master节点的核心服务,否则会因文件被占用而导致恢复失败。
(1) 模拟故障与停止服务
为了演示,我们先模拟一个故障:删除default命名空间下的所有Pod。
[root@k8s-master ~]# kubectl get pod
No resources found in default namespace.现在开始恢复。首先停止服务。对于使用kubeadm部署的集群,其核心组件(包括etcd)是以静态Pod方式运行的,我们只需将它们的清单文件移出/etc/kubernetes/manifests/目录,kubelet就会自动停止对应的容器。
# 将manifests目录移动到备份位置
mv /etc/kubernetes/manifests/ /backup/
# 查看移动后的备份目录
ll /backup
# 此时集群已不可用,执行命令会失败或超时
kubectl get node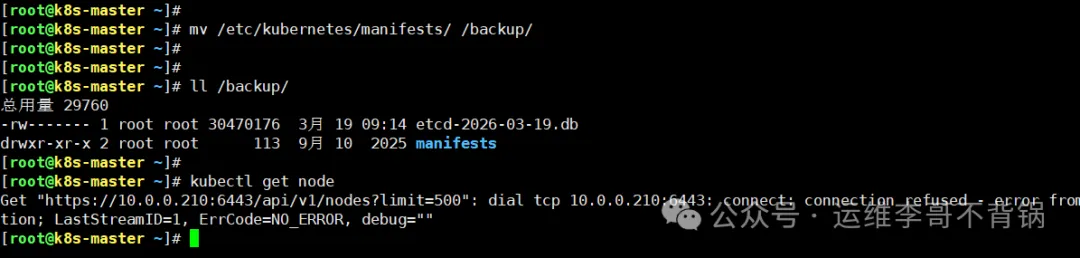
如果是二进制方式部署的集群,组件通常由systemd管理,直接使用systemctl stop命令停止相关服务即可。
(2) 恢复 etcd 数据
服务停止后,使用之前备份的快照文件进行恢复。注意:--data-dir参数需要指定一个全新的目录,不能直接指向原有的/var/lib/etcd目录。
etcdctl snapshot restore /backup/etcd-2026-03-19.db \
  --data-dir=/backup/etcd-new
(3) 替换数据目录
恢复命令会在指定目录生成新的etcd数据文件。接下来,我们用这些新文件替换掉旧的数据目录。
# 备份原有数据目录(以防万一)
mv /var/lib/etcd /var/lib/etcd-old
# 将恢复出来的新数据目录移动到标准位置
mv /backup/etcd-new /var/lib/etcd
(4) 启动服务并验证
数据就位后,将组件的清单文件移回原处,kubelet会自动启动Pod。
mv /backup/manifests/ /etc/kubernetes/
# 等待片刻,查看集群状态
kubectl get node
可以看到集群节点恢复为Ready状态。此时再检查之前被删除的default命名空间的Pod,应该也已经恢复了。这说明基于etcd快照的集群级恢复已经成功完成。对于二进制部署的集群,执行systemctl start启动相关服务即可。
5. 多 Master 节点恢复(生产环境重点)
多Master高可用集群的恢复,是生产环境中最容易“翻车”的环节。其核心逻辑与单节点不同,这里不展开具体命令,重点强调几个必须牢记的原则和流程。
(1) 核心原则
多Master恢复,本质上等同于重建整个etcd集群。 这意味着你不能只恢复其中一个节点,而是必须对集群中的每一个etcd节点都执行恢复操作,并且要使用同一份备份快照文件。
(2) 正确流程
标准的操作流程是:停止所有Master节点的组件 -> 在每个Master节点上分别执行restore操作 -> 最后统一启动所有服务。
① 恢复 master1 节点
在第一个节点上执行恢复时,命令需要包含完整的集群初始化信息:
etcdctl snapshot restore /backup/etcd.db \
  --data-dir=/var/lib/etcd-new \
  --name=master1 \
  --initial-cluster=master1=https://IP1:2380,master2=https://IP2:2380,master3=https://IP3:2380 \
  --initial-advertise-peer-urls=https://IP1:2380
② 恢复 master2 / master3 节点
在另外两个节点上执行恢复命令时,--snapshot和--initial-cluster参数保持不变,但需要修改以下两个参数以匹配当前节点:
--name:改为当前节点的名称(如master2)。--initial-advertise-peer-urls:改为当前节点的对等通信地址。
③ 启动组件
所有节点恢复完成后,将之前移走的静态Pod清单文件(对于kubeadm)移回原目录,或者启动systemd服务(对于二进制部署),etcd集群便会基于恢复的数据重新组建。
6. etcdctl vs Velero
最后,我们来澄清一下etcdctl和Velero的关系,这也是很多人的困惑点。
(1) Velero 是什么?
Velero是一个Kubernetes原生的备份恢复工具,它的操作对象是Kubernetes资源本身,例如Pod、Deployment、Service、PVC等。它支持按命名空间、按标签选择器进行备份和恢复,非常适合用于应用迁移、环境复制、特定业务恢复等场景。
(2) 能力对比
用一个简单的比喻来理解:
- etcdctl:相当于恢复整个集群的“数据库”。当集群彻底崩溃、etcd数据损坏时,它是最后的救命稻草。但它恢复的是“某一时刻”的完整状态,无法做到细粒度恢复。
- Velero:相当于恢复“业务对象”。当你误删了某个应用,或需要将A集群的应用迁到B集群时,它非常高效。但它依赖于一个健康的Kubernetes控制平面。
所以,它们是互补的。一个稳健的生产环境灾备方案,往往会同时使用etcdctl和Velero:用etcdctl做整个集群的周期性全量快照(灾难恢复兜底),用Velero做应用级的频繁增量备份(应对日常误操作)。
最后,也是最重要的提醒: 以上所有涉及恢复的操作,尤其是多节点恢复,务必先在测试环境中反复演练并跑通后,才能在生产环境执行。灾难恢复,容不得半点侥幸。


