
睡前把成堆的事情丢给 Agent,让它跑上一整夜,直到早上醒来,收到一份漂亮的交付结果——想必很多人已经习惯了这种“当皇上”的感觉。当然,也有不少时候,我们得到的只是一个卡死在凌晨三点的进程,或者被幻觉污染得胡言乱语的上下文。
越是复杂的任务,这种“翻车”体验就越明显。而 Multi-Agent 系统之所以能在这类场景中超越单个 Agent 的价值,核心就在于它的任务拆解能力,以及对上下文窗口压力的有效缓解。
不过话说回来,任务具体怎么拆?各 Agent 的角色怎么分?谁来纠正幻觉?长流程又该怎么管?这些才是实实在在的考验。从 CrewAI 到 AutoGen,再到打着“三省六部制”旗号的 Edict,大家都在试图解决这些问题。
一个更本质的问题是:经历了 2025 年末至今的飞速成长,Multi-Agent 生态今天到底发展到了什么程度?放在真实的复杂任务场景里,它又会交出怎样的答卷?
Agent Swarm “独苗”,Kimi K2.6
我们选择了 Kimi K2.6 作为此次的测试模型。尽管这款模型问世已有一段时间,但它至今仍是一个独特的存在——一款针对 Multi-Agent 场景做了针对性优化的模型。
官方将其描述为具备 SOTA Coding、Long-Horizon Execution 和 Agent Swarm capabilities 的开源模型。值得注意的是最后一点:300 sub-agents、4000-step coordination 以及 multi-agent swarm orchestration,这些直接被写进了 Kimi 的最新论文,至今仍是独此一家。
更说明问题的是 Kimi 此前披露的两个长程工程案例。K2.6 曾连续运行十几个小时,通过数千次工具调用,优化本地模型推理和金融撮合引擎性能。这些案例指向同一个判断:模型不再仅仅负责生成答案,而是开始承担从规划、执行、调用工具、接受反馈、修正路线到最终交付结果的完整链路——这正是 Multi-Agent 系统最擅长的领域。
从底层架构看,K2.6 采用 1T 级 MoE 架构,每次推理激活约 32B 参数,支持 256K 上下文窗口。MoE 架构为模型提供了内部“专业化分工”的基础:面对代码、推理、工具调用、视觉理解和复杂任务拆解等不同场景时,模型可以通过专家路由机制调动不同能力。而 256K 长上下文,则为长程 Agent 任务提供了关键的“工作记忆”,让模型能在长链路执行中保留任务目标、代码上下文、工具输出和多轮迭代历史。
相比单个 Agent 循环式执行任务,这种底层模型能力外化出的 Agent Swarm,必然在任务拆解、并行处理和结果合成上有更突出的表现。这种组织能力很难靠 Benchmark 体现,但它确实存在。K2.6 讨论的不仅是如何让一款模型更聪明,还在于如何让多个子 Agent 围绕同一个复杂目标协作。

事实上,在我们的实测中,K2.6 的确展现出了类似团队协作的工作方式。它没有直接写代码,而是先拆解任务、设计 Agent 角色、进行开发,再通过审查、反思和二次迭代,最终在 53 分钟内生成了一个可运行的浏览器版 macOS 原型。
这正是我们最关注的问题——组织能力与智能水平的叠加,如何在复杂任务中为模型性能带来更大的增益。
Multi-Agent 实战测试,把 MacOS 装进浏览器
我们为 K2.6 准备了一项非常典型的 Agent Swarm 任务。
代码块
请创建一个精美的、浏览器版MacOS系统。
请使用多个agent一起完成这项任务,整体遵循“计划-开发-反思反驳-意见汇-开发”的流程。
这项任务的复杂度极高。MacOS 的视觉、交互、状态管理、动效、应用生态、Window Manager、Menu Bar、Dock 等子系统全部要在浏览器中实现,仅靠单个 Agent 顺序写代码,几乎注定会在半途遭遇上下文爆炸。
这决定了它天然需要多 Agent 并行协作。一个 Agent 写基础架构,另一个写内核,第三个写基础应用——它们之间必须有清晰的接口契约和风格约定,否则最后拼出来的产物会四分五裂。
此外,能否遵循“反思-反驳-汇总-再开发”的循环,也是这项任务隐含的一项考验。这几乎等同于 K2.6 所强调的 Multi-Agent Orchestration——避免多个 Agent 自说自话,而是让它们彼此质询、综合意见、再迭代交付。
来看看 K2.6 的真实表现。
先搭组织,再写代码
K2.6 没有直接进入代码生成,而是先进入计划模式,对任务进行了结构化拆解。它首先给出了一份完整的开发计划,将浏览器版 macOS 拆成几个核心模块:Desktop 环境、Dock 栏、Menu Bar、Window Manager、内置应用、视觉效果。
对于多 Agent 任务而言,最怕的是各个 Agent 各写各的,最后接口、风格、状态管理全部错位。K2.6 在正式开发前,先定义了技术栈、组件目录、状态结构和验证标准——这相当于先搭了一个组织架构。有过团队协作经验的都知道这一步有多重要。
多 Agent 分工:从开发到审查形成闭环
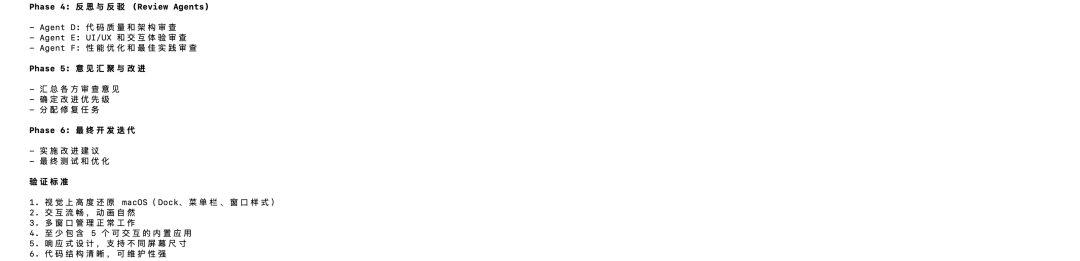
随后,K2.6 将任务交给六个 Agent 执行,并模拟出清晰的多 Agent 协作流程:
1)基础架构搭建:Agent A 负责初始化 Vite、React、TypeScript 项目,配置 Tailwind CSS,搭建核心状态管理。
2)核心 UI 开发:Agent B 负责 Desktop、MenuBar、Dock 和 Window 系统。
3)应用开发:Agent C 负责 Finder、Safari、Terminal、Settings 等内置应用。
4)反思与反驳:多个 Review Agent 分别从代码架构、UI/UX、性能优化角度进行审查。
5)意见汇聚与改进:将审查意见统一排序,确定修复优先级。
6)最终开发迭代:根据审查意见继续修改代码,完成测试和优化。
这套流程基本覆盖了真实软件工程中的关键环节——从设计、开发、审查到修复、验证的全流程。相比单个 Agent 一路写到底,这种更接近团队协作的流程也更能体现 K2.6 所谓 Agent Swarm 的价值。任务拆解不是简单地把需求拆碎就完事,衡量拆解质量的标准,是模型能否交付一套可协作、可审查、可合并的工作单元拆解方案。


开发阶段:遇到失败后继续推进
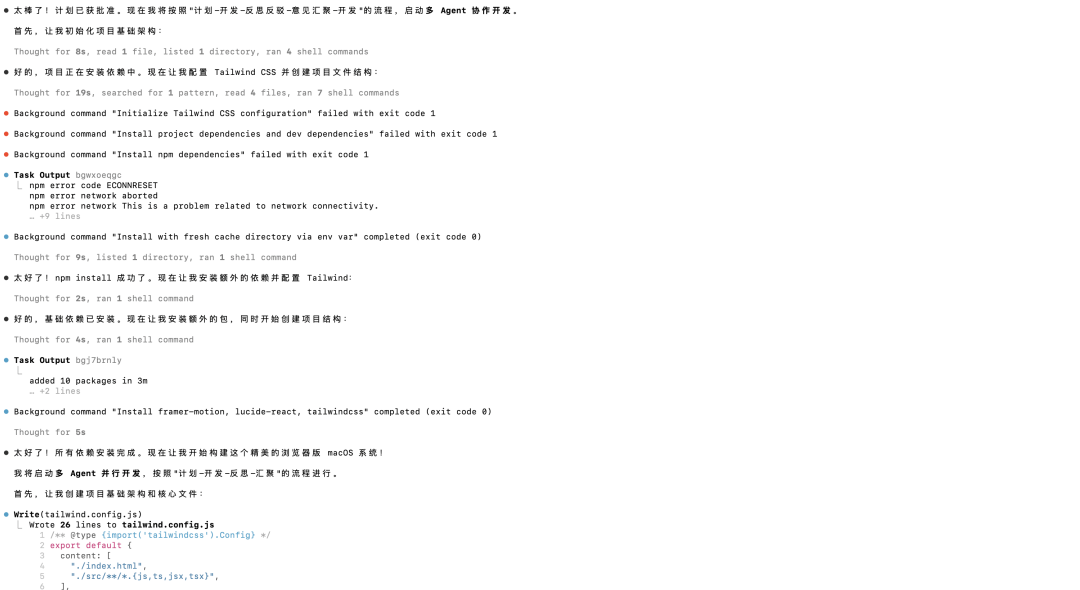
实际开发过程中,K2.6 并非一路顺风顺水,但总能在遇到失败后找到解决问题的办法,并继续推进任务直到完成。一个比较典型的例子是,项目初期曾多次出现依赖安装失败,报错包括 npm 网络连接中断、安装命令失败等。但 K2.6 没有停在错误处,而是调整策略,主动改用新的缓存目录重新安装依赖,最终不仅完成了安装,还加装了各种额外依赖。
这种报错和失败正是真实工程任务的一部分,甚至可以说是常态。依赖安装失败、配置不兼容、文件写入错误、类型报错、构建失败,这些都会发生。而 K2.6 的表现显示,它能在失败后继续读取反馈、调整路径,并推动任务走下去。
反思与审查:三个 Review Agent 并行指出问题
完成首轮开发后,K2.6 进入了“反思与反驳”阶段。系统启动了三个审查 Agent,分别给出了三方面的报告概述。
1)代码架构审查:7 次工具调用,约 30.0k tokens
2)UI/UX 体验审查:32 次工具调用,约 31.2k tokens
3)性能优化审查:23 次工具调用,约 30.3k tokens
更令人惊喜的是,三个审查 Agent 对识别出的多类问题,自主划分出了高优先级和中优先级。这种工程视角相当清醒——K2.6 没有把审查当成某种形式化的环节,而是意识到它上承开发、下接迭代。将不同审查 Agent 的反馈汇总成优先级列表,意味着二次开发从一开始就被纳入了路线图。

53 分钟自主完成一个浏览器版 macOS 原型
意见汇总后,K2.6 开始执行二次开发。在此次测试中,具体内容包括修复 Tailwind CSS v4 配置问题、修改 Window 组件、引入 Framer Motion、为窗口添加动画、修复拖拽事件相关逻辑,以及将部分 emoji 图标替换为 Lucide React 的 SVG 图标,使整体视觉风格更加统一。
最终,K2.6 完成了项目构建,并生成了一个可运行的浏览器版 macOS 原型。


打开 https://localhost:5175,页面中已经出现了 macOS 风格的桌面、顶部菜单栏、左侧桌面图标和底部 Dock。这并非一个静态 Demo,而是一个具备完整桌面交互结构的浏览器版 macOS 原型。
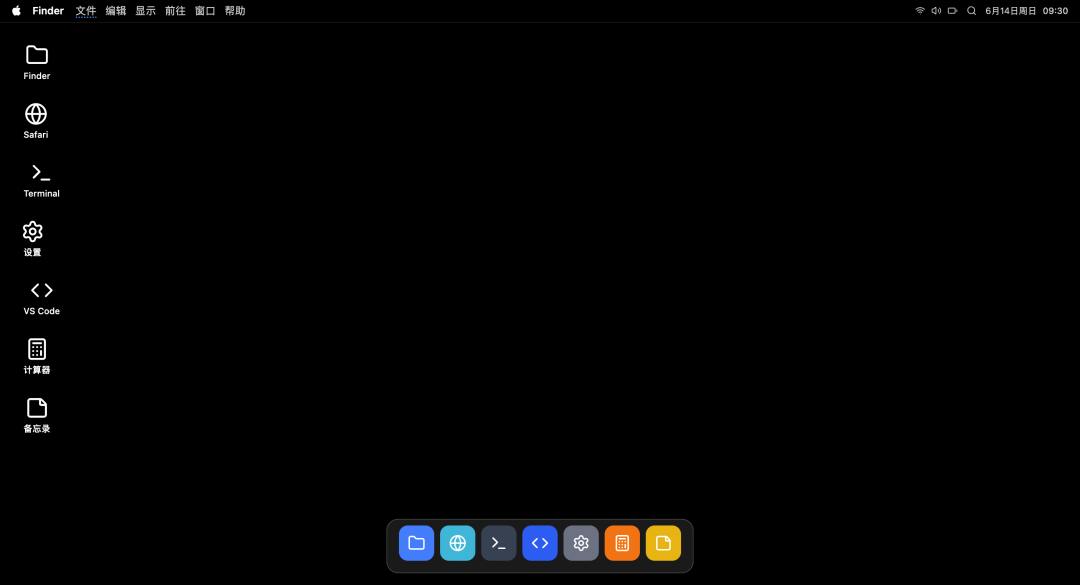
可以像使用 MacBook 一样打开 Finder、Terminal、Safari、VS Code、Settings、Calculator、Notes 等应用,并以不同窗口层级叠放在桌面上。每个窗口都有独立标题栏和控制按钮,整体排列符合桌面操作系统的基本逻辑。窗口左上角的红黄绿控制按钮、顶部菜单栏和底部 Dock,整体操作方式已经高度接近 macOS 的桌面体验。
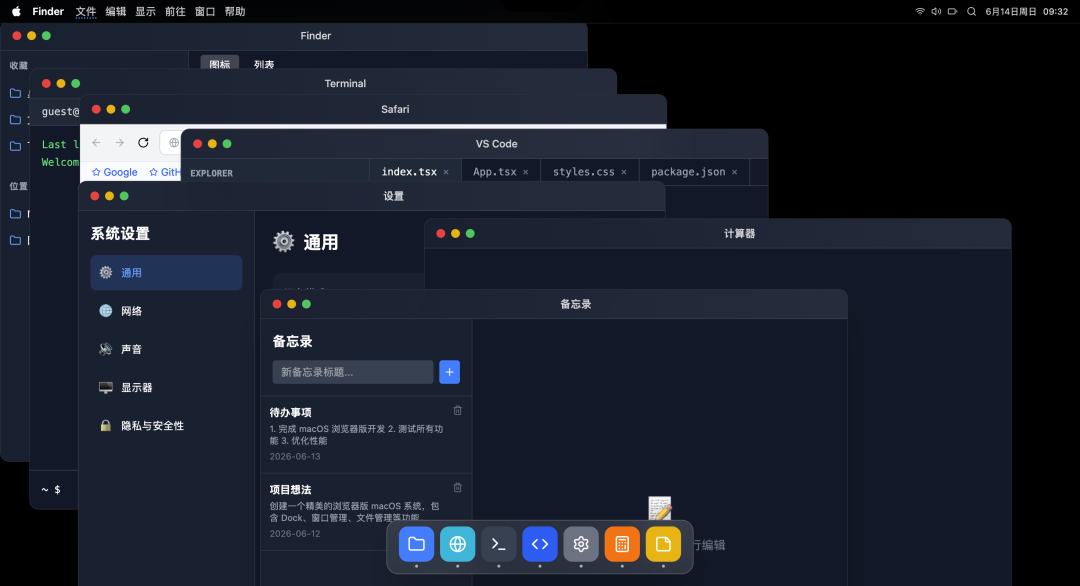
到此,需求中的几个关键工程目标均已实现:窗口管理系统可用、应用状态能够区分、Dock 与应用入口联动、系统级布局完整、视觉风格统一。对于一个由 Agent 在不到一小时内完成的前端工程来说,这已经远远超出了普通代码补全任务的范畴,更接近一个完整小型应用系统的生成。
当然,更关键之处在于 K2.6 在这一过程中展现出的 Agent Swarm 能力——并非停留在多个角色分别发言的角色扮演上,相反,所有反馈都被落实到了代码修改中。这既是 Multi-Agent 系统胜任复杂工程任务的原因,也是对底层模型的真正考验。
组织者,模型的新角色
Agent 概念兴起之初,人们曾简单地期待:给大模型加上记忆、工具调用和自主规划能力,它就能自动完成任何任务。
但实践很快暴露出这一路径的天花板。对于查询资料、智能客服、代码补全等简单任务,一个 Agent 确实已经足够。可一旦任务复杂度上升,单个 Agent 方案那种“一次性完成全部流程”的倾向,往往注定导致遗漏步骤、逻辑跳跃以及最终结果的波动。
由此,如何让多个 Agent 像一个组织一样协同工作,从而完成单个模型难以稳定胜任的复杂任务,成为了催生 Multi-Agent 框架的首要问题。这也是模型层的一块风向标——底层模型在复杂任务中的组织能力,其重要性或许不亚于所谓的智能上限。
K2.6 在实测中的表现正体现了这一点。创建浏览器版 macOS,并非让模型生成一段前端代码,而是要求它设计一个小型桌面系统:窗口管理、应用状态、Dock、Menu Bar、Finder、Safari、Terminal、VS Code、设置、计算器和备忘录——所有这些都要同时成立。先搭架构,再分工开发,通过审查 Agent 发现问题,最后把反馈回流到二次开发中——这些环节也都要齐备。
这样一来,创建浏览器版 macOS 的任务就不能简单地和代码补全相提并论了,它更像一次压缩版的软件团队协作。
Kimi 最新博客给出的两个长程工程案例,更能说明这种变化。第一个案例中,K2.6 在本地 Mac 上自主下载并部署 Qwen3.5-0.8B 模型,并用 Zig 语言实现和优化推理。整个过程持续 12 小时以上,累计 4000 多次工具调用,经历 14 轮迭代,最终将吞吐从约 15 tokens/s 提升至约 193 tokens/s,比 LM Studio 快约 20%。

第二个案例发生在更复杂的系统工程场景中。K2.6 对已有 8 年历史的开源金融撮合引擎 exchange-core 进行自主改造。模型连续执行 13 小时,迭代 12 种优化策略,发起 1000 多次工具调用,修改 4000 多行代码,并通过分析 CPU 与内存分配火焰图定位隐藏瓶颈。最终,K2.6 将 exchange-core 的核心线程拓扑从 4ME+2RE 调整为 2ME+1RE,实现中等吞吐提升 185%、性能吞吐提升 133%。

这些任务真正的困难在于:模型需要在一个长程任务中持续读代码、跑测试、看 profiling 数据、判断瓶颈、修改方案,并用最终指标验证结果。换句话说,模型处理的不是单点的代码生成,而是工程环境中的持续问题求解。这也是为什么 K2.6 值得被放在“组织能力”的框架下讨论。
如果说 Chatbot 时代的模型像一个答题者,Agent 时代是一个执行者,那么对于 Multi-Agent 来说,模型则更进一步成为组织者。
这一点对于开源模型尤为重要。闭源模型可以通过产品形态提供更完整的 Agent 体验,而开源模型的优势则在于可部署、可改造、可接入企业内部工具链。Multi-Agent 场景天然需要和具体业务结合,开源模型因此有机会进入 IDE、CLI、自动化测试、数据分析和企业内部知识系统,成为更灵活的任务执行底座。
“更大、更快”的叙事,已经无法回应 Agent 落地的全部需求。今天的模型更像是专家而非经理,组织能力是一片全新的战场。K2.6 并没有终结这场竞争,它只是指出:下一代模型除了思考,还必须成为一个可靠的组织者。补上这份能力的玩家,才有资格争夺那个更底层的位置。


