

根据技术报告,Kimi K3在编程、智能体、推理与视觉等数十项基准测试中,表现超越了所有开源模型,甚至多数闭源模型。在Arena Intelligence的WebDev Arena中,Kimi K3以1679 Elo登顶,成为首个在该榜单夺冠的开源模型;Artificial Analysis Intelligence Index v4.1得分57.1,排名全球第四。当然,报告也坦诚指出,整体性能仍略逊于Claude Fable 5和GPT-5.6 Sol。 这次开源最引人注目的并非参数规模本身,而是Kimi K3在GPU与芯片算力层面展现出的自主工程能力。 技术报告显示,在GPU内核优化测试中,Kimi K3在24小时内独立完成了AttnRes、DeepSeek Sparse Attention、KDA和MLA这四种代表性内核的优化。其中,AttnRes的延迟从283.6毫秒降至114.4毫秒,DSA和KDA的运行时间分别减少了55.1%和73.6%,MLA更是接近峰值TFLOPS。该表现与Claude Fable 5持平,但明显优于Claude Opus 4.8、GPT-5.6 Sol和GPT-5.5。 需要特别指出的是,测试环境覆盖了NVIDIA H200,同时也包含了来自其他供应商的GPGPU。这意味着,Kimi K3的部署能力已不再局限于英伟达生态系统。 报告还提到,Kimi K3自主开发了一个名为MiniTriton的紧凑型GPU编译器,从Python前端到PTX代码生成,全链路均由模型完成。在NVIDIA L20上,其性能甚至超越了PyTorch eager、torch.compile和标准Triton的实现。
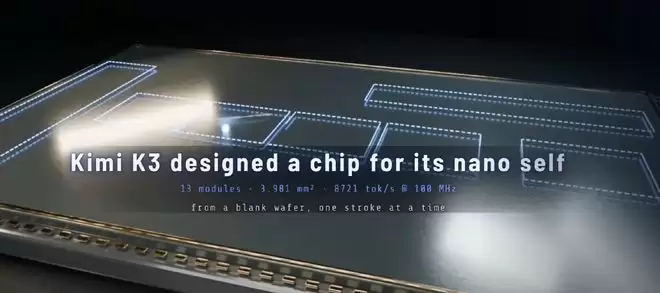
作为早期的概念验证,技术报告还披露了一个有趣的细节:Kimi K3在48小时自主运行中,基于开源EDA工具和Nangate 45nm工艺库,完成了一款推理芯片原型的设计、优化与验证。这块芯片面积仅4平方毫米,集成了146万个标准单元、0.277MB SRAM,以及带融合去量化的INT4 MAC阵列。它是一款由模型设计、为模型服务的芯片,标志着AI已具备从算法到硬件的全栈自主工程能力。 与模型权重同步开源的还有三项基础设施技术:MoonEP是为超大规模MoE设计的高性能专家并行通信库,可实现完美负载均衡;FlashKDA是KDA注意力机制的高性能算子,在英伟达H20上的预填充速度相比基线提升了1.72到2.22倍;AgentEnv是与KVCache.ai合作开发的智能体沙箱系统,支持快速快照、恢复与Fork,主要面向大规模Agent训练环境。 月之暗面表示,本次开源旨在加速前沿智能的部署与普及,促进AGI研究。随着Kimi K3完整权重、技术报告及核心Infra技术的同步开放,开源大模型已正式迈入2.8万亿参数阶段。


