
大模型在企业界落地速度越来越快,但一个隐形的瓶颈正在浮出水面——AI推理系统的效率问题。上下文长度持续膨胀,用户并发请求量急速攀升,传统GPU显存架构已经有些力不从心了。想释放算力潜力,又要保证性能、控制成本,这几乎成了企业掘金AI必须跨越的门槛。
好消息是,开放数据中心委员会(ODCC)最近有了大动作。由NVIDIA、美团、三星、Solidigm等产业链头部企业联合支持的AI存储实验室,首次发布了针对大模型推理关键制约因素——KV Cache的专项评测结果。测试结论相当震撼:焱融科技自研的YRCache推理存储系统,在推理性能上实现了数量级跃升,同时成本得到革命性优化,为AI规模化落地提供了一套全新的“存储驱动推理”范本。
权威测试数据揭晓:TTFT与TPOT降低97%,吞吐量提升22倍
作为国内专业AI存储厂商,焱融的YRCache专为大规模推理场景而生。它通过构建GPU显存、主机内存、本地NVMe SSD以及YRCloudFile高性能分布式存储的多级缓存架构,目标很明确:扩展KV缓存空间,彻底打破显存限制。这次测试基于NVIDIA的计算和网络平台,在真实推理环境中运行,采用的是DeepSeek-R1等主流大模型,覆盖了中端GDDR GPU和高端HBM GPU两种算力节点。网络带宽从200Gbps到800Gbps都有覆盖,对比的是原生vLLM框架和集成YRCache后的系统性能。
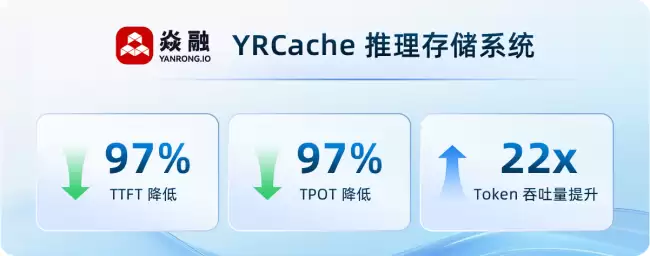
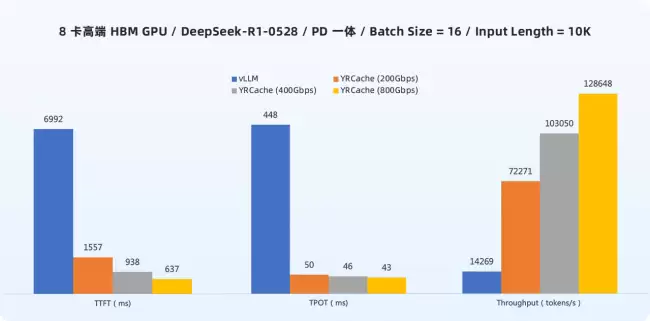
结果有多夸张?看几组数据。在Batch值为16、输入长度10K Tokens的典型场景下,集成YRCache后,首Token延迟(TTFT)和单个Token生成时间(TPOT)优化幅度高达97%,系统Token吞吐量最高提升22倍。这意味着用户会体验到“即问即答”的瞬时响应,长文档生成也能做到如丝般顺滑。更关键的是,系统吞吐能力大幅增强,可以服务更多并发用户,单Token成本也跟着同步往下掉。

长上下文场景:表现稳定,增益持续放大
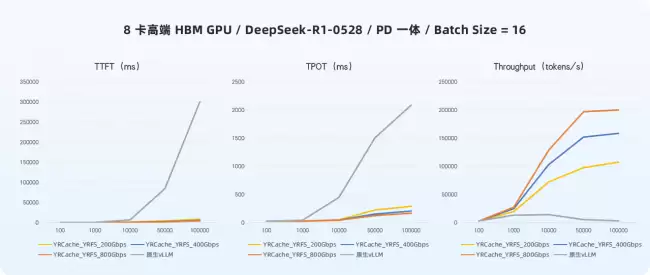
更让人放心的是,在模拟输入Token从100扩展到100K的测试中,YRCache始终保持稳定性能优势。上下文越长,加速效果反而越明显。这对企业做长文档分析、多轮对话等高负载任务来说,意味着技术底气十足——再也不用担心性能随着上下文增长而断崖式下跌了。

中低配GPU:推理性能追平高配,成本结构性优化
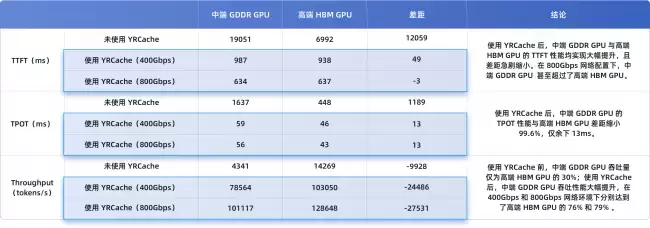
这才有意思的地方。测试揭示了一项更具战略价值的成果。在YRCache加持下,中端GDDR GPU服务器的综合推理性能,已经大幅逼近甚至在某些维度上媲美高端HBM GPU原生方案。原生状态下,中端GPU吞吐量只有高端的30%,但用了YRCache后,差距急剧缩小,可以达到高端HBM GPU的79%。
投资回报率飙升14倍,重构AI推理经济模型
商业价值更直观地体现在投入产出比上。从测试数据推算,虽然原生状态下中端GDDR GPU表现不占优,但引入YRCache优化后,其ROI相比原生高端HBM GPU方案,在400Gbps和800Gbps网络环境下分别提升了11倍和14倍。这意味着同样的资金投入,采用“中端GDDR GPU服务器 + YRCache”方案,能带来远超高端HBM GPU原生方案的推理产出效率。
这等于直接重构了企业AI推理的成本结构——当推理成本的重心从依赖高端GPU转向依托存储技术创新,AI应用的盈亏平衡点会大幅下移。中小企业能以更低门槛部署高性能推理服务,大规模AI企业则能显著优化TCO。更多创新场景的经济可行性大门,正在被推开。

迈向“存储驱动推理”的新范式
这次ODCC的首发评测,不只是验证了焱融YRCache的技术实力,更重要的是标志着“以存促算、架构降本”这条AI推理新路径的可行性。作为ODCC AI存储实验室的重要实践,这套测试为行业提供了可量化、可复现的技术参考,推动AI存储技术向标准化、规范化迈进。
ODCC AI存储实验室透露,接下来会持续推进KV Cache系列测试,深化“部件—系统—应用”全栈协同。焱融科技也明确强调,YRCache同时支持PD(Prefill-Decode)分离等下一代推理架构,用“数量级性能提升 + 碘伏性成本优化”的双重能力,帮助企业以更低成本、更高效率在AI规模化落地的浪潮中抢占先机。


