
自监督学习(Self-Supervised Learning,简称SSL)是Yann LeCun自2017年以来持续推动的研究方向,也是JEPA世界模型的基础构建模块。SSL的核心优势在于无需人工标注,即可从海量数据中提取通用的表征。然而,这一技术始终面临一个关键挑战——表征坍塌(representation collapse)。简单来说,就是模型“偷懒”,将所有不同输入映射到同一个或少数几个向量上,训练看似完成,实际并未学到有区分度的特征。
为解决这一问题,主流方法大多依赖各种启发式技巧:EMA、教师-学生网络、停止梯度、冻结层等。这些技巧使得训练过程变得脆弱,参数调优困难,同时也削弱了方法的可解释性与可扩展性。
另一条技术路线则通过正则项直接约束表征的分布。
LeCun团队此前提出的VICReg,将学习目标拆分为方差、不变性和协方差三项,利用协方差约束各维度之间的相关性。但问题在于,协方差只能刻画二阶统计量,无法区分“均值、方差相同,但分布形状完全不同”的两种表征。
后续的SIGReg基于Cramér–Wold定理,采用sketching技术将整个嵌入分布对齐到标准高斯分布,从而约束了分布的整体形状。然而,SIGReg仍存在两个关键缺陷:
- 坍塌时梯度消失:当表征开始坍塌时,SIGReg的梯度也随之衰减——坍塌越严重,修正信号越弱,模型难以自行恢复。
- 尺度与形状耦合:它未能将“幅度大小(尺度)”与“分布形态(形状)”这两个独立属性分开,导致两者在优化过程中相互干扰,尤其在处理长尾、低质量、低秩数据时表现不佳。
换言之,在模型最需要梯度信号逃离坍塌状态时,SIGReg的梯度偏偏趋近于零。
这正是VISReg要解决的核心问题。
近日,自监督学习领域的新工作VISReg(Variance-Invariance-Sketching Regularization)获得了图灵奖得主Yann LeCun的连续转发和高度评价。他在转发时评价道:“VICReg begat SIGReg which begat VISReg”(VICReg孕育了SIGReg,SIGReg又孕育了VISReg),一句话便点明了这条正则化路线的技术传承。
能得到LeCun如此认可,VISReg究竟强在哪里?
答案在于:它精准击中了LeCun长期押注的JEPA世界模型的核心难题——表征坍塌。
VISReg将防止坍塌的正则项解耦为“尺度”与“形状”两个独立目标。在不依赖任何启发式训练技巧、也不依赖海量数据的前提下,它在15个数据集上的综合表现超越了7种主流自监督学习方法。更值得一提的是,它仅用了约十分之一的训练数据,就在分布外(OOD)基准上追平了DINOv2。
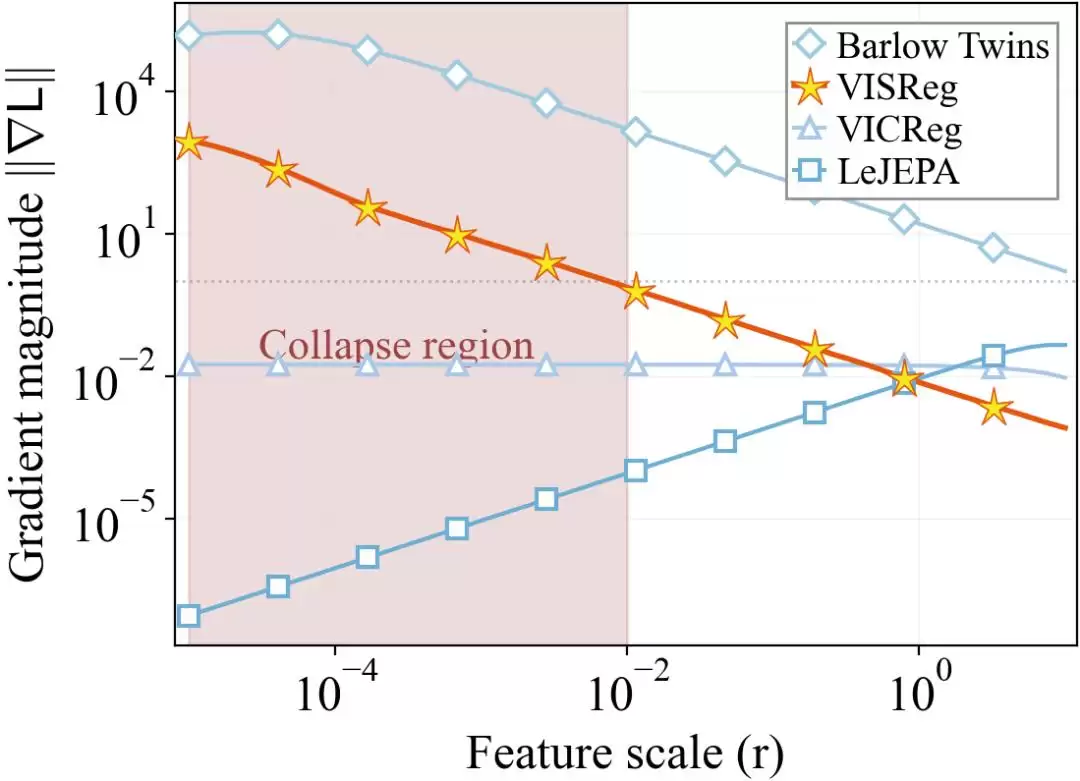
图2:不同正则方法在表征坍缩各阶段的梯度幅值模拟。VISReg在坍缩状态下仍能保持强梯度,而SIGReg的梯度几近消失。
核心方法
VISReg对VICReg和SIGReg取长补短:它保留了VICReg的方差项来控制尺度,同时用基于切片Wasserstein距离(Sliced Wasserstein Distance,SWD)的sketching目标替代了协方差项来控制形状,并通过停止梯度将两者彻底解耦。整个正则目标由三部分组成。
1. 尺度正则
第一部分约束每一维的方差,防止幅值坍缩:
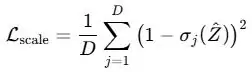
关键之处在于,当模型坍缩时,该项的梯度趋近于一个常数,从而保证模型能够稳定地恢复——这恰好弥补了SIGReg梯度消失的缺陷。
2. 形状正则
第二部分先归一化以消除尺度影响,再单独约束形状。关键的一步是带“停止梯度”(stop-gradient, sg)的归一化:
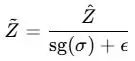
这里对标准差施加了停止梯度,使得形状损失的优化不会反过来改变尺度——这正是“尺度”与“形状”两个目标真正解耦、互不干扰的机理所在。
归一化之后,再用切片Wasserstein距离将分布的几何形状对齐到各向同性高斯分布:
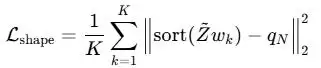
其中,

为标准高斯分位数,

为随机投影方向(即“切片/sketching”)。
其理论依据是Cramér–Wold定理:两个分布相等,当且仅当它们沿单位球面上所有方向的一维投影都相等。因此,只要将高维表征沿足够多的随机一维方向切片后逐一对齐到高斯分布,就等价于在高维空间对齐了整个分布——这使得可以用廉价的一维排序操作来刻画完整的分布形状,而不仅仅是二阶统计量。
3. 合并目标
第三部分是一个将batch均值拉向原点的中心化损失:
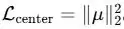
三个正则项按权重组合:
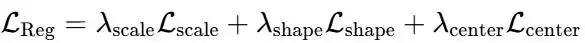
预测损失沿用JEPA/LeJEPA的不变性目标——让各视角的嵌入都向全局视角的均值对齐:
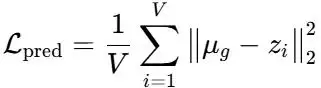
最后用单一超参在预测与正则之间平衡,得到完整目标:
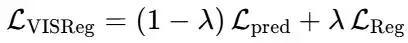
与VICReg的对比:VICReg同样将正则解耦为方差+协方差,但协方差只刻画二阶统计量;VISReg用基于切片Wasserstein的sketching目标完整刻画了分布形状,同时保留方差项做尺度控制——既保留了VICReg的灵活性,又获得了分布层面的严格性。
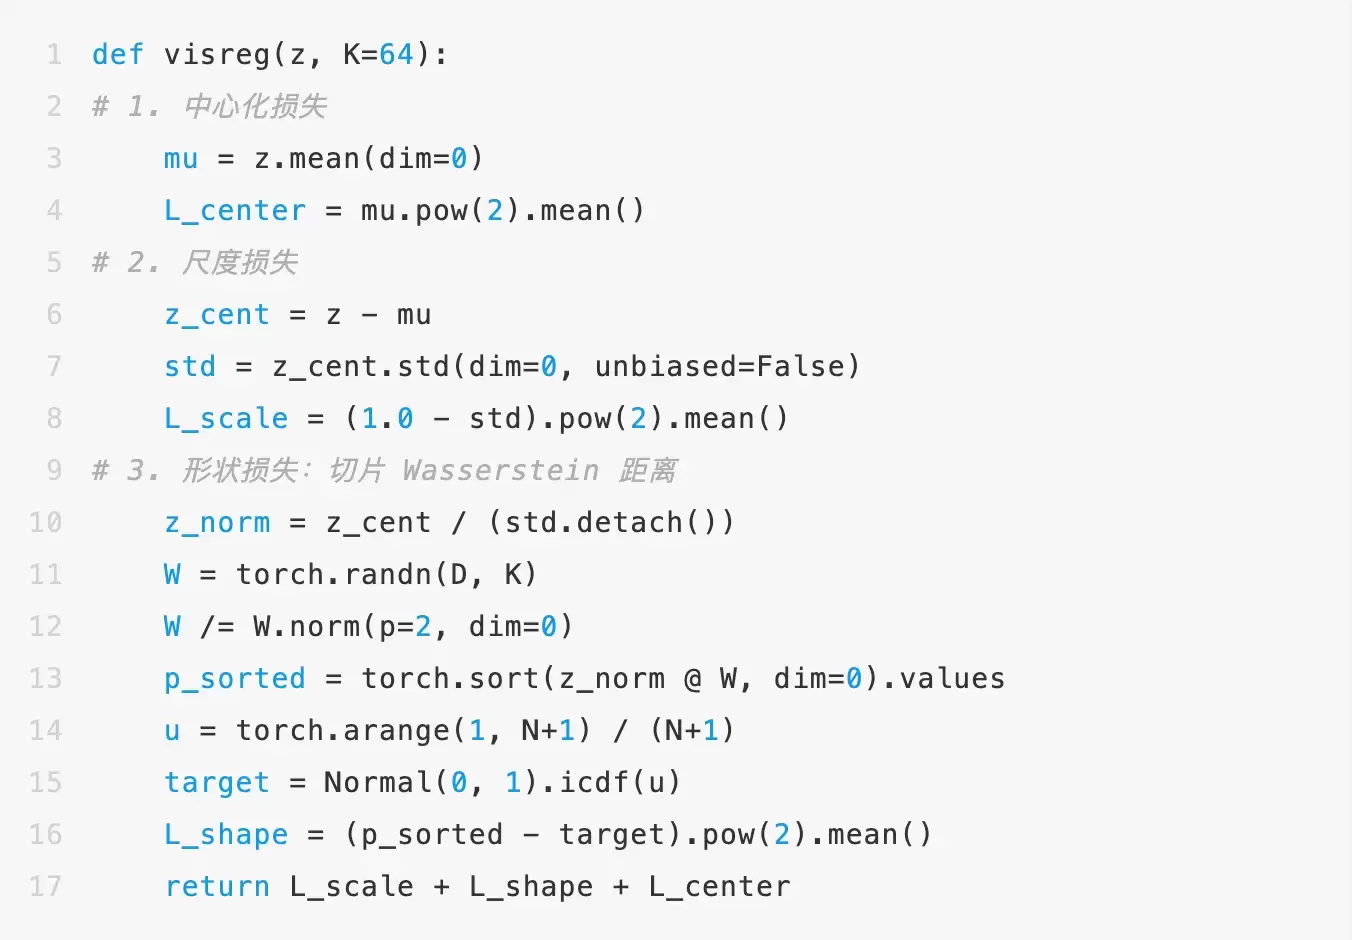
仅需约15行PyTorch代码
这个正则目标在实现上非常轻量,核心逻辑只需约15行代码:
计算复杂度与扩展性
在计算与扩展性上,VISReg同样具备优势。其正则部分的计算复杂度对所有扩展因子都是线性的;相比之下,VICReg的协方差项随维度平方增长。
在同等batch规模下,VISReg在单块H100 GPU上的运行速度与显存占用均优于SIGReg。
更重要的是,K个随机切片可以分摊到多块GPU上:在M块GPU上每块各生成K/M个切片,效果等价于单卡生成全部K个。实验中,当单卡切片数不足时,改用8卡、每卡128个切片(合计1024),即可把与“单卡1024切片”之间的精度差距从约2.4%缩小到0.22%。这意味着扩大训练规模时,K可保持常数,几乎不增加单卡负担。
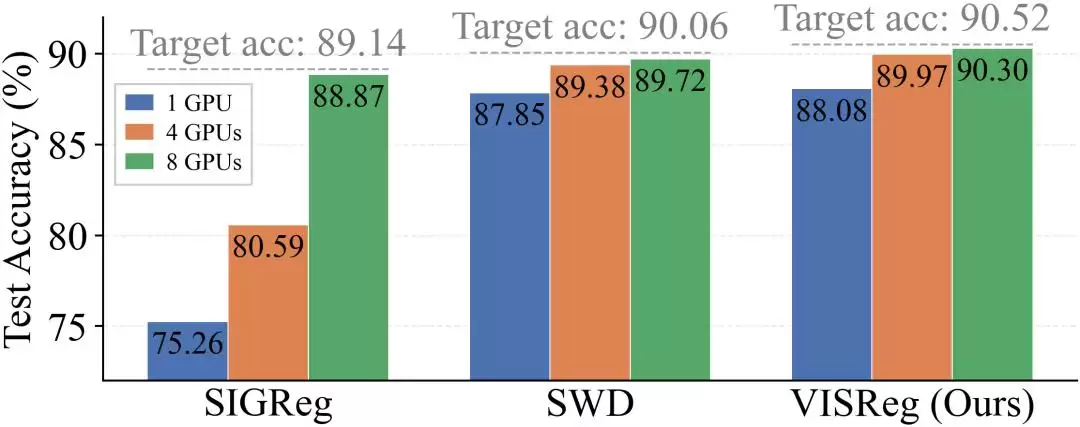
图:在固定K与D时,增加GPU数量带来的线性探测精度变化。当K不足时,用8倍的GPU数量即可把精度补齐到K = 2D的水平——这使得在大规模训练中保持常数K成为可能。
实验结果
回到标题的问题——VISReg到底强在哪里?研究团队在15个数据集(8个域内+6个分布外+ADE20K稠密预测)上,将VISReg与MoCoV3、DINO、iBOT、I-JEPA、MAE、data2vec等7种主流自监督方法进行了对比,场景涵盖天文、医疗、遥感、纹理、花卉等。答案体现在从识别到分割、生成的多个维度上。
1. 域内线性探测
为保证比较公平,实验按是否使用启发式技巧分为两组。在不使用任何启发式技巧的一组中,VISReg领先:ViT-B/16的域内线性探测精度达75.7%,高于MAE的75.1%;ViT-L/14进一步提升至77.0%,高于LeJEPA的75.6%。与使用启发式技巧的iBOT、DINO相比,VISReg在常规数据集上仅略低,但在纹理数据集DTD上反超了全部方法——这表明其跨域泛化能力源于方法本身,而非人工技巧的堆叠。
2. 分布外泛化:全面最优
分布外泛化是比域内精度更严格的检验:依赖启发式的方法常在ImageNet域内被充分调优,却未必能迁移到差异较大的新分布。研究团队在覆盖医疗、天文、遥感、纹理的6个OOD数据集上进行了评测,这些数据集与ImageNet训练域完全无关。结果显示,VISReg在所有方法、所有骨干规模上都取得了最佳的平均OOD精度,甚至超过部分使用启发式技巧、且骨干更大的方法。
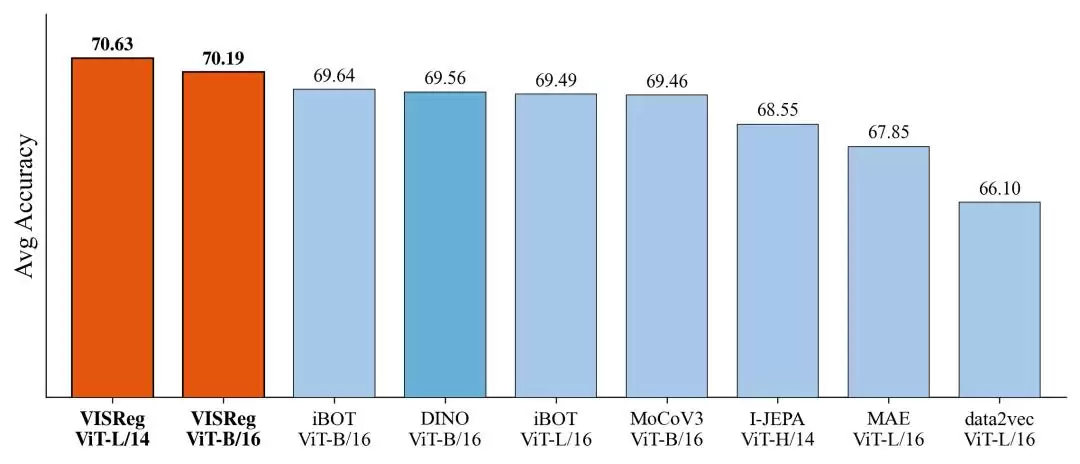
图4:平均OOD线性探测精度。VISReg全面优于iBOT、DINO、MoCoV3、I-JEPA、MAE、data2vec等方法。
如图4所示,ViT-B/16的VISReg平均OOD精度为70.19%,ViT-L/14为70.63%,明显高于MAE的67.85%,并优于MoCoV3的69.46%、DINO的69.56%、I-JEPA的68.55%等方法。
3. 数据效率:以1/10数据比肩DINOv2
将VISReg(ViT-L/14)在ImageNet-22K(约1400万张图像)上预训练后,其6个OOD数据集的平均精度达72.94%,与在10倍规模的LVD-142M(1.42亿张图像)上训练的DINOv2(72.93%)基本持平。也就是说,VISReg以约十分之一的数据达到了同等水平。(作为对照,同为ViT-L/14、但仅用ImageNet-1K预训练的VISReg平均精度为70.63%。)这说明其学到的表征具有很强的通用性。
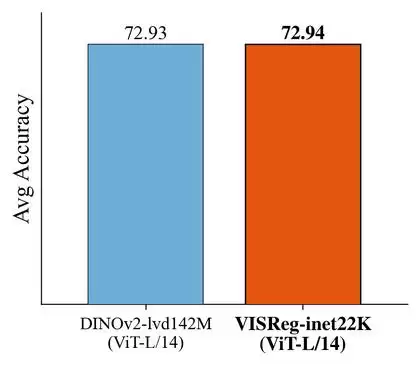
图5:在ImageNet-22K上预训练的VISReg,在OOD基准上比肩用10倍数据训练的DINOv2。
4. 迁移微调:全面超过DINO
尽管VISReg在部分域内数据集上的线性探测精度略低于DINO,但经过微调后,它在CIFAR-10、CIFAR-100、Flowers、ImageNet-1K、Galaxy10全部五个数据集上均超过DINO与有监督预训练——这表明其表征分布更均匀、冗余更低、可迁移性更强。
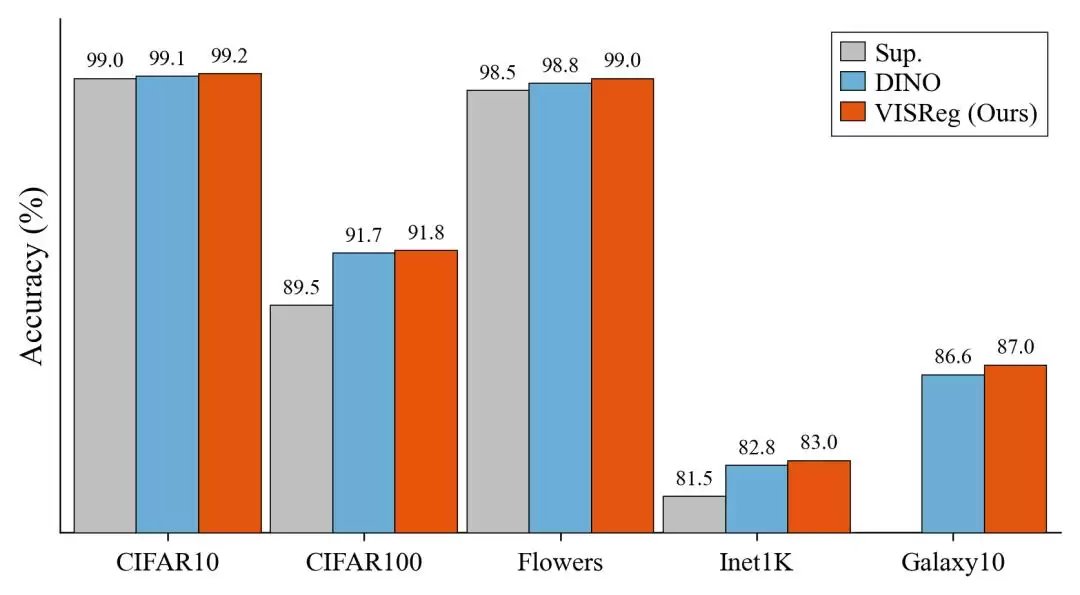
图:迁移学习对比。微调后,VISReg在所有测试数据集上都优于DINO与有监督预训练。
5. 稠密预测与生成引导
VISReg的优势不局限于分类。在ADE20K线性语义分割上(ViT-B/16),其mIoU为30.16,高于DINO的29.40与MAE的23.60,仅次于MoCoV3的31.69;在不使用任何启发式技巧的前提下,这一结果具有竞争力。论文也坦言,稠密预测与最佳方法仍有差距,是后续优化的重点。
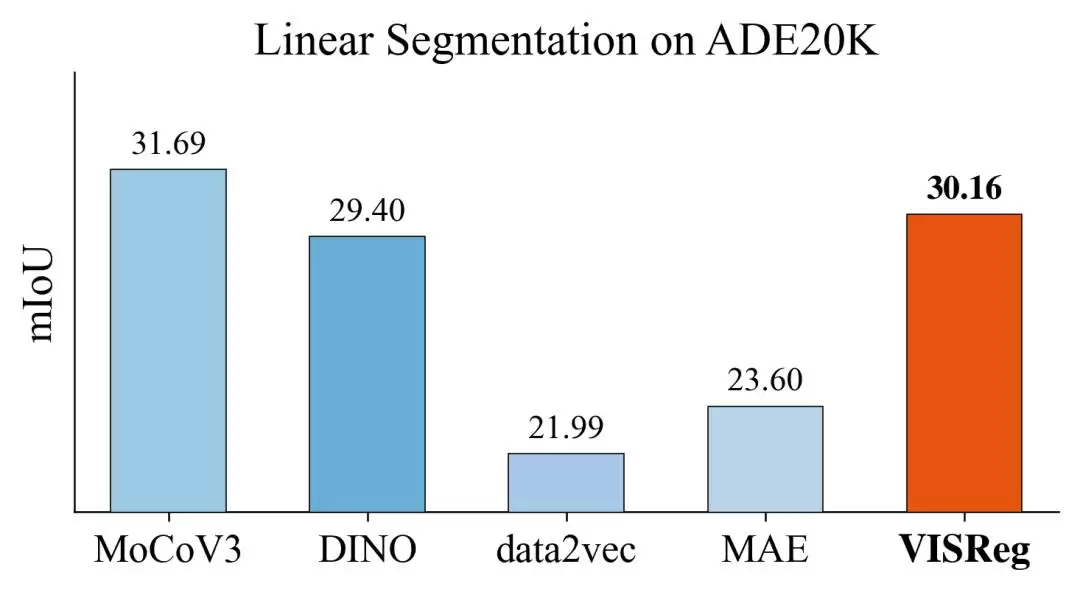
图7:ADE20K上的线性语义分割。在不使用任何启发式技巧的情况下,VISReg取得了具有竞争力的mIoU,仅次于MoCoV3。
在生成引导上(SiT-B/2,iREPA框架,10万步训练),由VISReg特征引导的生成在四项指标中的三项优于DINO:gFID 40.36(DINO 41.15)、Precision 51.38(DINO 50.51)、Recall 61.26(DINO 60.70),IS基本持平(33.48 vs 33.47)。这说明VISReg学到的表征作为生成引导信号同样更优。
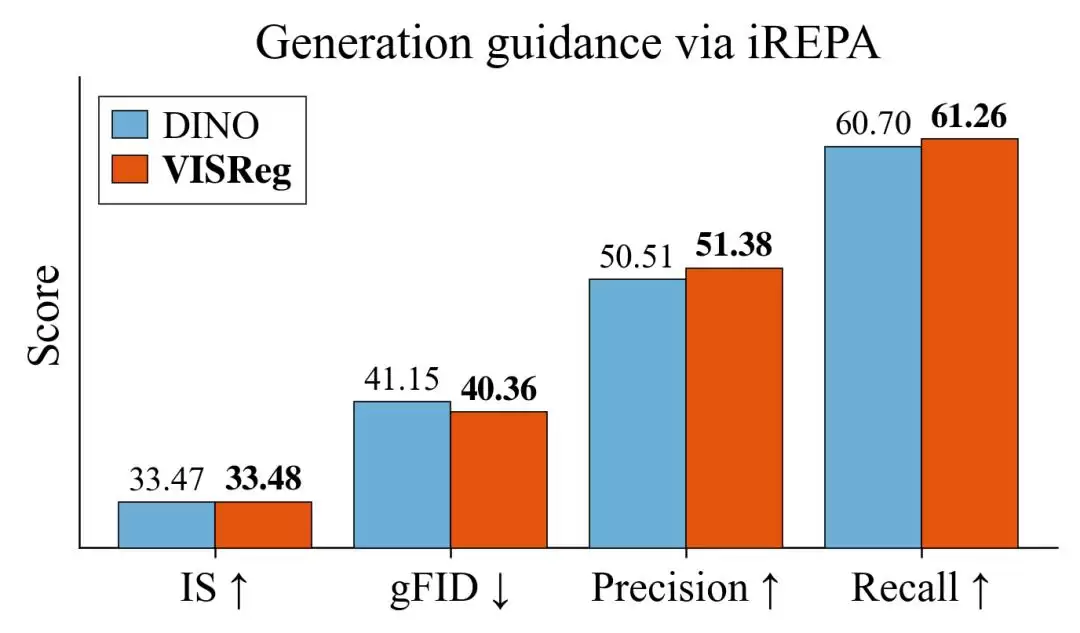
图8:使用SiT-B/2、分别由VISReg与DINO特征引导的图像生成。VISReg在多数指标上都提供了更好的引导。
6. 低质量数据上的鲁棒性
在长尾分布(ImageNet-LT)与低秩(Galaxy10)等低质量数据集上,VISReg能稳定地防止坍塌并学到有意义的表征,而DINO在缺乏精细调参时直接失败。
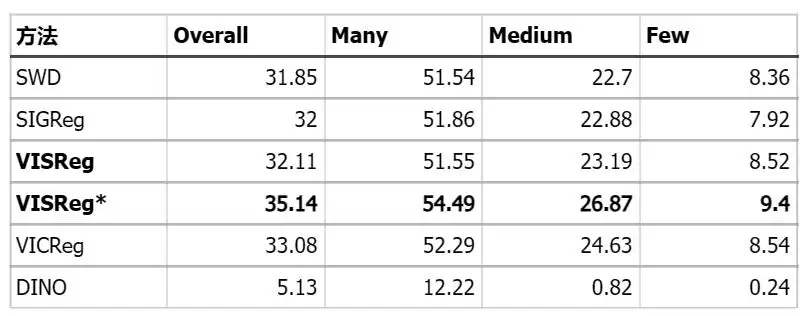
表1:ImageNet-LT上的线性探测精度
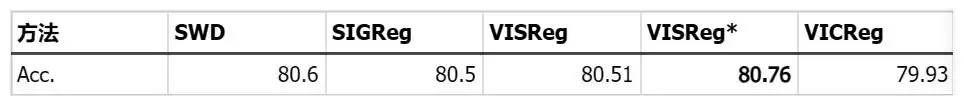
表2:Galaxy10上的域内线性探测精度
结论
VISReg表明:将表征正则解耦为“尺度”与“形状”两个独立组件,可以得到一种比现有方法更稳定、更高效、泛化性更强的自监督学习方法。
在不使用任何训练启发式技巧的前提下,它在图像识别、分割与生成引导等多个维度上取得了领先或接近领先的结果,并以约十分之一的数据达到了DINOv2的OOD水平。这为JEPA世界模型长期存在的表征坍塌问题提供了一种新的正则化解法。


