
数据源灵活切换是构建高可用、高性能数据库应用的核心技术之一。尤其在复杂业务场景下,一个系统同时对接多个数据库,按需路由、动态切换早已成为刚需,关键在于如何优雅且稳定地实现。今天,我们将从原理架构、代码实现、配置策略、进阶用法到优劣势,全面剖析MyBatis多数据源动态切换技术栈。
一、原理架构
MyBatis 管理数据源的核心,其实隐藏在 DataSource 接口的抽象与路由机制中。单数据源场景下,配置直接指向一个具体的数据库连接池,一步到位。但一旦进入多数据源领域,就必须引入一个“路由层”——它不生产连接,只是连接的搬运工,根据业务规则动态决定你该连哪个数据库。
1.1 核心架构组件
下面这张图展示了多数据源切换的整体架构,包括上下文管理、路由数据源以及实际的数据源工厂:
核心原理说明:
- Configuration/Environment:MyBatis 的全局配置,传统模式下这里只能配置一个 Environment,显然无法满足多数据源需求。
- DynamicDataSource:这就是切换的关键角色。在 Spring 生态中,我们通常继承
AbstractRoutingDataSource。它内部维护了一个Map,存储了 Key(比如 "master"、"slave")到真实DataSource的映射。 - DataSourceContextHolder:一个基于 ThreadLocal 的工具类,专门用来在当前线程中存储数据源的 Key,确保数据源的选择在同一个线程内透传,不会串到别的请求里去。
二、核心工作流程与代码实现
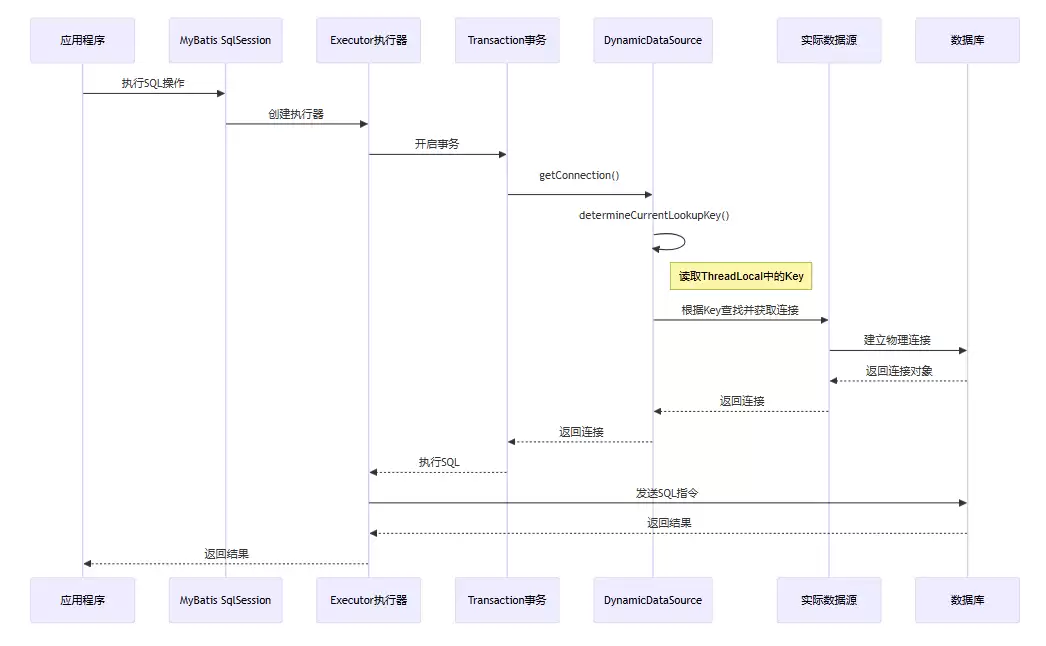
要理解一个关键点:数据源切换并不是发生在 SQL 解析阶段,而是发生在获取数据库连接(Connection)的那一刻。也就是说,MyBatis 在真正需要拿连接的时候,才会去问路由层“你要用哪个库?”
2.1 工作流程时序图
下面这张图清晰地展示了从 Service 层调用到获取数据库连接的完整时序:
2.2 关键代码实现
要实现上述流程,我们需要编写三个核心部分:上下文管理器、动态数据源类和配置类。
上下文管理器 (DataSourceContextHolder)
利用 ThreadLocal 保证线程隔离,这是最基础也最关键的保障。
public class DataSourceContextHolder {
    private static final ThreadLocal CONTEXT_HOLDER = new ThreadLocal<>();

    public static void setDataSourceKey(String key) {
        CONTEXT_HOLDER.set(key);
    }

    public static String getDataSourceKey() {
        return CONTEXT_HOLDER.get();
    }

    public static void clearDataSourceKey() {
        CONTEXT_HOLDER.remove();
    }
}
动态数据源
继承 Spring 的 AbstractRoutingDataSource,实现路由逻辑。
import org.springframework.jdbc.datasource.lookup.AbstractRoutingDataSource;

public class DynamicDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        // 直接从上下文中获取Key
        return DataSourceContextHolder.getDataSourceKey();
    }
}
三、动态数据源实现架构与配置
下图展示了我们在代码中需要构建的类体系及其依赖关系:

3.1 Spring Boot 配置示例
需要配置多个真实的数据源 Bean,并将它们注入到 DynamicDataSource 中。
@Configuration
public class DataSourceConfig {

    @Bean
    @ConfigurationProperties(prefix = "spring.datasource.master")
    public DataSource masterDataSource() {
        return DataSourceBuilder.create().build();
    }

    @Bean
    @ConfigurationProperties(prefix = "spring.datasource.slave")
    public DataSource slaveDataSource() {
        return DataSourceBuilder.create().build();
    }

    @Bean
    @Primary
    public DynamicDataSource dynamicDataSource(
            @Qualifier("masterDataSource") DataSource masterDataSource,
            @Qualifier("slaveDataSource") DataSource slaveDataSource) {

        Map targetDataSources = new HashMap<>();
        targetDataSources.put("master", masterDataSource);
        targetDataSources.put("slave", slaveDataSource);

        DynamicDataSource dynamicDataSource = new DynamicDataSource();
        dynamicDataSource.setTargetDataSources(targetDataSources);
        dynamicDataSource.setDefaultTargetDataSource(masterDataSource);

        return dynamicDataSource;
    }
}
四、数据源切换策略与用法
如何决定使用哪个数据源?常见的策略包括注解驱动、方法名约定和手动切换。下面这张图梳理了常见的路由策略:

4.1 策略一:自定义注解 + AOP(推荐)
这是最优雅的方式,对业务代码的侵入性最小,也是大多数成熟项目采用的方式。
第一步:定义注解
@Target({ElementType.METHOD, ElementType.TYPE})
@Retention(RetentionPolicy.RUNTIME)
@Documented
public @interface TargetDataSource {
    String value() default "master";
}
第二步:定义 AOP 切面
@Aspect
@Component
public class DataSourceAspect {

    @Before("@annotation(targetDataSource)")
    public void before(JoinPoint point, TargetDataSource targetDataSource) {
        String dataSourceKey = targetDataSource.value();
        if (StringUtils.isNotBlank(dataSourceKey)) {
            DataSourceContextHolder.setDataSourceKey(dataSourceKey);
            System.out.println("切换数据源到: " + dataSourceKey);
        }
    }

    @After("@annotation(targetDataSource)")
    public void after(TargetDataSource targetDataSource) {
        DataSourceContextHolder.clearDataSourceKey();
    }
}
第三步:业务使用
@Service
public class UserService {
    @Autowired
    private UserMapper userMapper;

    @TargetDataSource("master")
    public void addUser(User user) {
        userMapper.insert(user);
    }

    @TargetDataSource("slave")
    public User getUserById(Long id) {
        return userMapper.selectById(id);
    }
}
4.2 策略二:手动编程式切换
有些场景下,路由逻辑非常复杂,比如根据前端传入的参数决定租户库,这时手动切换反而更灵活。
public void processOrder(Long userId, Order order) {
    try {
        String shardKey = "shard_" + (userId % 4);
        DataSourceContextHolder.setDataSourceKey(shardKey);
        orderMapper.insert(order);
    } finally {
        DataSourceContextHolder.clearDataSourceKey();
    }
}
五、进阶场景:读写分离架构
读写分离是多数据源最经典的应用场景。应用层通过 AOP 或拦截器,自动将 SELECT 请求发送至从库,INSERT/UPDATE/DELETE 发送至主库。下图展示了经典的读写分离架构:

实现思路:可以结合 MyBatis 的 Plugin(插件)机制,在 SQL 执行前解析 SQL 语句类型。如果以 SELECT 开头,则调用 DataSourceContextHolder.setDataSourceKey("slave"),否则设为 master。
六、优势与劣势分析
任何技术方案都有其适用场景。下面这张图详细对比了该技术的优势与劣势:

6.1 劣势详解:事务边界问题
这是多数据源最大的坑,也是面试中高频被问到的点。Spring 的 @Transactional 注解是基于线程绑定的 Connection 来管理的。如果在一个事务方法中切换了数据源,Spring 的事务管理器可能无法感知,或者直接导致事务失效。
错误示例:
@Transactional
public void updateAndRead() {
    userMapper.updateUser(user); // 使用 Master 连接

    DataSourceContextHolder.setDataSourceKey("slave");

    // 问题:事务管理器仍持有 Master 的连接,这里可能并不会真的切换,
    // 或者抛出异常,因为 Connection 已经绑定在事务中了。
    userMapper.selectUser(id);
}
解决方案:
- 避免事务内切换:将读写操作拆分到不同的事务方法中。
- 编程式事务:使用
TransactionTemplate精确控制事务边界。 - 分布式事务:如果必须跨库操作,需要引入 Seata 等分布式事务框架,但这通常用于跨库写,读写分离场景下一般允许最终一致性。
七、配置实现全流程
下面这张图描述了从零开始搭建动态数据源的完整配置步骤:

八、进阶应用场景与演进
随着业务复杂度的提升,数据源切换技术也衍生出了多种高级应用场景。下面这张图展示了多数据源技术在不同阶段的应用场景及演进:

技术演进时间线:

九、总结
MyBatis 的数据源切换机制,本质上是 AbstractRoutingDataSource 和 ThreadLocal 的巧妙组合,为我们提供了一种轻量级、灵活的数据路由方案。核心要点回顾:
- ThreadLocal 是灵魂:它保证了在多线程环境下,每个请求的数据源选择互不干扰,你走你的阳关道,我过我的独木桥。
- AOP 是翅膀:通过切面将数据源选择逻辑从业务代码中剥离,保持代码整洁,避免遍地都是 setDataSourceKey 的混乱。
- 事务是双刃剑:在使用多数据源时,务必清醒地认识事务边界的限制,避免在事务内切换导致不可预知的问题。
在实际项目中,建议从简单的读写分离开始,逐步根据业务需求引入更复杂的路由策略,并做好充分的监控与容错准备。毕竟,技术是为业务服务的,稳定可靠才是第一优先级。


