
NVIDIA 官方技术博客近日发布了重磅技术解析,首次系统性地揭晓了下一代 Rubin GPU 架构的完整设计理念。与之前在 CES、GTC 上披露的产品规格不同,本次重点不再局限于 FP4 算力、HBM4 等基础参数,而是深入阐述 Rubin 如何围绕 Agentic AI(智能体 AI)进行架构重构——简而言之,就是为未来更复杂的推理、规划、多 Agent 协作场景量身打造核心计算单元。

背后的逻辑非常清晰:生成式 AI 时代依赖大规模训练,但未来 AI 计算的重心将逐步转向推理、规划、多 Agent 协作以及工具调用。这类工作负载具备三大特征——上下文更长、数据交换更频繁、CPU 与 GPU 协同需求更高。因此,GPU 架构的优化目标也必须从单纯堆叠峰值算力,转向全面提升系统吞吐率、能效以及每 Token 成本。

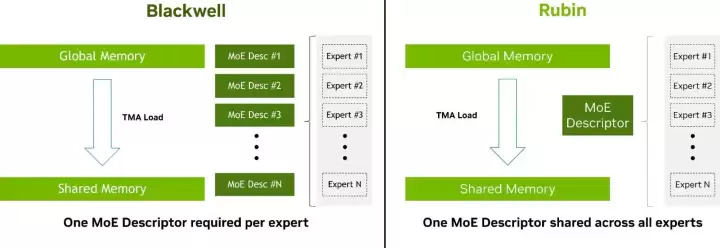
Rubin GPU 为此在多个关键模块进行了重新设计。其中,Tensor Memory Accelerator(TMA)得到进一步增强,专门用于降低专家模型(MoE)等复杂负载中的数据搬运开销。通过更灵活的描述符管理机制,大幅减少 GPU 等待数据的时间,使计算单元保持更高利用率。NVIDIA 指出,这实际上是在解决一个现实瓶颈:大模型推理的计算速度越来越快,但数据供给反而成为制约性能的关键因素。
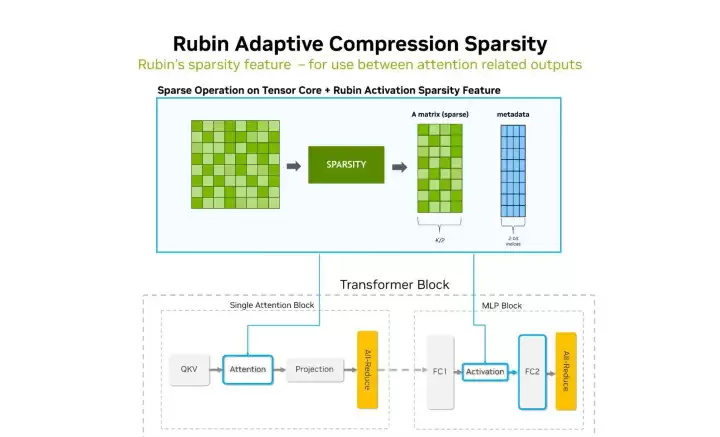
另一项重要升级来自第三代 Transformer Engine。此次新增了 Adaptive Compression(自适应压缩)能力,能对 KV Cache 等推理数据执行动态压缩。在尽量保持模型精度的前提下,显著降低 HBM 带宽占用,从而有效缓解长上下文推理带来的显存压力。换句话说,Rubin 不仅依靠 HBM4 更高的物理带宽来提升性能,更通过软硬件协同优化来提升显存利用效率。
从产品规格来看,Rubin 平台延续了此前公布的信息:单颗 GPU 最高可达 50 PFLOPS(NVFP4)AI 算力,配备 HBM4 高带宽显存,并与 Vera CPU 组成新一代 Vera Rubin 平台。整机层面,Vera Rubin NVL72 由 72 块 Rubin GPU 和 36 颗 Vera CPU 构成,专门针对大规模 AI 推理和后训练(Post-training)场景进行了深度优化。
值得关注的是,NVIDIA 此次还首次披露了更多产业合作伙伴的部署进展。CoreWeave、Google Cloud、Microsoft Azure、Mistral AI 等均已基于 Vera Rubin 平台开展测试与部署。官方强调,新平台的目标不仅仅是提升峰值性能,更重要的是降低每瓦性能成本(Performance per Watt)和每 Token 生成成本(Token Cost),助力 AI 工厂获得更高的整体运行效率。
从行业发展视角来看,这次官方博客释放的信号非常明确。随着 AI 产业进入以推理为主的新阶段,GPU 竞争已经不再局限于算力数字,而是扩展到了 CPU 协同、内存系统、互连网络、软件栈乃至整机架构。Rubin GPU 的正式公开,意味着 NVIDIA 正在重新定义 AI 基础设施的设计标准——将 GPU 从单一计算芯片,进一步演进为 AI Factory 的核心计算节点。


